Segmentation 3D de tumeurs cérébrales
Cinq architectures de deep learning entraînées sur des IRM cérébrales 3D, d'un CNN de référence jusqu'à un Transformer. Un modèle de 2,4M de paramètres a égalé un modèle de 62M. Tout a été construit et comparé de zéro sur un GPU grand public.
24 min de lecture
- Python
- PyTorch
- MONAI
- Imagerie médicale
- Segmentation 3D
- Transformers
- MLflow
En bref
J’ai entraîné et comparé cinq architectures de segmentation 3D sur le jeu de données d’IRM cérébrales BraTS2021, en partant d’un CNN de référence, puis en passant par l’attention à portes, un Transformer global, une adaptation 3D d’un article hybride KAN de 2026 (étendu de la 2D à l’inférence volumétrique), et enfin une ablation KAN contrôlée. Chaque modèle a été entraîné sur une GTX 1070 Ti (8 Go de VRAM) avec seulement 150 des 1 251 cas d’entraînement disponibles, une contrainte matérielle qui a fini par produire des résultats vraiment intéressants. Je m’attendais à ce que le Transformer domine, et j’en suis ressorti avec une image très différente.
Le résultat principal : un CNN de 22M de paramètres avec des portes d’attention a battu un Transformer de 62M de paramètres. Un hybride KAN de 2,4M de paramètres a ensuite égalé le Transformer avec 26× moins de paramètres. Et une ablation contrôlée (une seule variable modifiée, tout le reste identique) a montré qu’en remplaçant uniquement les activations du bottleneck par des splines KAN, on battait de peu le mécanisme d’attention sur la métrique la plus importante cliniquement, le tout avec 12 % des données disponibles.
Le problème
Les tumeurs cérébrales ne se comportent pas de façon prévisible. Leur forme est irrégulière, elles varient énormément d’un patient à l’autre et se composent de plusieurs sous-types de tissus, dont un cœur nécrotique (NCR), un anneau d’œdème qui l’entoure (ED) et une zone de tumeur active qui prend le contraste (ET). Ces tissus n’ont pas du tout le même aspect selon la séquence IRM qu’on regarde. Les radiologues les délimitent généralement à la main, un processus lent et sujet à un biais qui varie d’un clinicien à l’autre.
Automatiser la segmentation 3D est intéressant parce que cela alimente directement des décisions cliniques comme la planification chirurgicale, le ciblage de la radiothérapie ou le suivi de l’efficacité d’un traitement. Bien segmenter, et savoir où le modèle doute, sont deux aspects très importants.
Le jeu de données du challenge définit trois sous-régions qui ont un sens clinique, chacune évaluée séparément parce qu’elles servent à des choses différentes.
| Région | Composition | Usage clinique |
|---|---|---|
| WT - Tumeur entière | NCR + ED + ET | Planification chirurgicale (quelle quantité de tissu est touchée) |
| TC - Cœur tumoral | NCR + ET | Caractérisation du cœur (la région activement dangereuse) |
| ET - Tumeur rehaussée | ET seul | Réponse au traitement (la tumeur rétrécit-elle vraiment ?) |
Le coefficient de Dice
La métrique principale est le coefficient de Dice, qui mesure à quel point la prédiction du modèle recouvre l’annotation de référence tracée par un radiologue expert. Il va de 0 (aucun recouvrement) à 1 (accord parfait).
Imaginez deux ensembles de voxels surlignés sur un scanner cérébral, l’ensemble P des voxels que le modèle prédit comme tumeur, et l’ensemble G de ceux que le radiologue a réellement annotés comme tumeur. Le coefficient de Dice donne la part des voxels que P et G classent tous les deux comme tumeur, plus précisément :
| Terme | Signification |
|---|---|
| |P ∩ G| | Voxels où le modèle et l'expert ont tous deux dit « tumeur » (le recouvrement) |
| |P| | Nombre de voxels que le modèle a prédits comme tumeur |
| |G| | Nombre de voxels que l'expert a annotés comme tumeur |
| Facteur 2 | Garantit qu'une prédiction parfaite (P = G) obtienne 1 et non 0,5 |
Si le modèle prédit parfaitement, , le recouvrement est égal aux deux ensembles et Dice = 1. Si le modèle rate tout, le recouvrement est nul et Dice = 0. Un modèle qui marque trop de voxels comme tumeur est pénalisé lui aussi, car un grand gonfle le dénominateur sans aider le numérateur.
Un score de 0,88, à peu près ce qu’atteint ce projet, signifie que le contour de tumeur du modèle concorde avec l’annotation de l’expert à environ 88 %. Comme on le verra plus bas, cela le place dans la même catégorie que des modèles entraînés sur les 1 251 cas complets.
Jeu de données et réalité matérielle
Le jeu de données du Brain Tumour Segmentation 2021 Challenge contient 1 251 IRM multiparamétriques préopératoires, chacune avec quatre modalités alignées et un masque tracé par un expert au niveau du voxel.
| Cas | 1 251 patients |
| Modalités | FLAIR - T1 - T1CE - T2 (4 canaux) |
| Taille des volumes | 240 × 240 × 155 voxels, 1 mm isotrope |
| Labels | 0 (fond) - 1 (NCR) - 2 (ED) - 4 (ET) |
| Code couleur | NCR = rouge - ED = jaune - ET = cyan |
Pourquoi seulement 150 cas ?
La réponse honnête, c’est le matériel. Ce projet a tourné sur une GTX 1070 Ti, un GPU grand public avec 8 Go de VRAM et sans Tensor Cores. C’est une vraie contrainte quand on travaille avec des volumes médicaux en 3D.
Un seul scanner cérébral fait 240×240×155 voxels sur quatre modalités. Charger un volume complet en mémoire GPU prend à lui seul plusieurs gigaoctets, il est donc tout simplement impossible de faire une passe avant-arrière sur un cerveau entier d’un coup. La solution est l’entraînement par patches. On découpe au hasard des sous-volumes de 128×128×128 et on s’entraîne dessus, avec l’échantillonneur de MONAI biaisé vers le premier plan pour que le modèle voie plus souvent des patches contenant de la tumeur que du fond pur.
Même avec des patches, entraîner un modèle sur les 1 251 cas prendrait plusieurs jours. Avec quatre architectures à comparer, on parle de semaines, ce qui n’est pas réaliste pour un projet personnel. Se limiter à 150 cas d’entraînement et 50 cas de validation garde chaque entraînement dans une durée raisonnable, tout en restant assez grand pour voir si un changement d’architecture aide vraiment.
Le même découpage fixe, généré une seule fois avec une graine aléatoire et réutilisé pour chaque modèle, garantit des comparaisons équitables. Toute différence de Dice vient de l’architecture, pas d’un artefact du découpage des données.
Le rythme pratique, c’était des entraînements de nuit. On lance un run avant d’aller se coucher, on regarde les chiffres le matin. Les modèles CNN ont pris environ 7 heures chacun, Swin UNETR en a pris 17. À un moment, j’ai envisagé de louer de la puissance de calcul dans le cloud. Pour à peu près le prix d’un café, on pourrait faire tourner Swin UNETR sur les 1 251 cas sur une V100 en quelques heures. J’ai choisi de ne pas le faire. Le but du projet était de comprendre les architectures et de construire le pipeline, pas de courir après le meilleur score possible. Cela dit, c’est une amélioration facile si j’y reviens un jour.
Ce qui m’a vraiment surpris, c’est à quel point les résultats ont fini par être compétitifs. Le score TC de l’Attention U-Net, 0,884, arrive à 0,004 du vainqueur du challenge BraTS2021, qui s’entraînait sur les 1 251 cas avec une vraie puissance de calcul. Le score ET bat carrément à la fois la fourchette publiée dans l’article original de l’Attention U-Net et les résultats de Swin UNETR sur le jeu complet. Je ne m’y attendais pas, et ce constat s’est confirmé pour chaque modèle entraîné. Pour ce problème, du moins dans ce régime de données, les choix d’architecture semblent compter autant que le volume de données.
Superpositions de segmentation
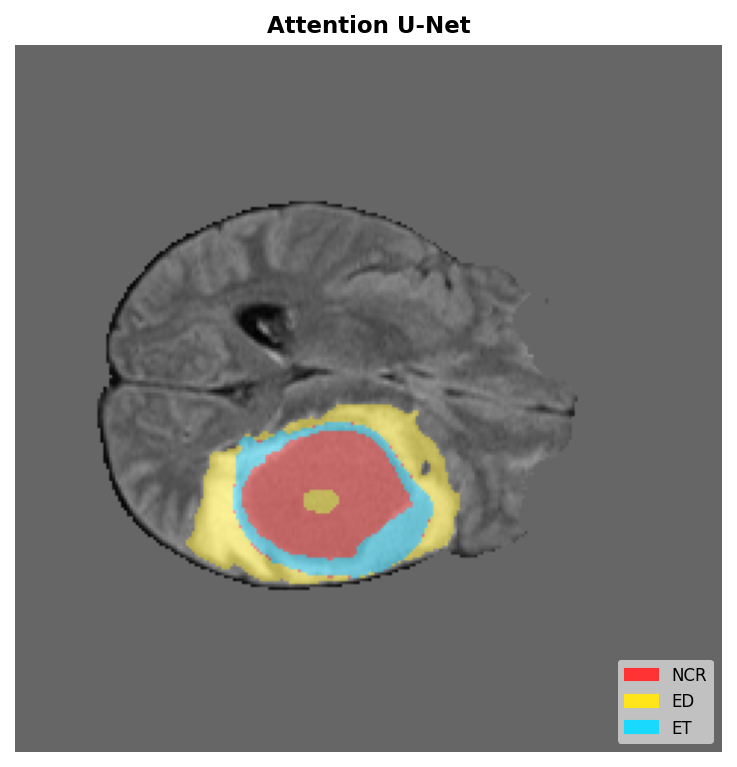
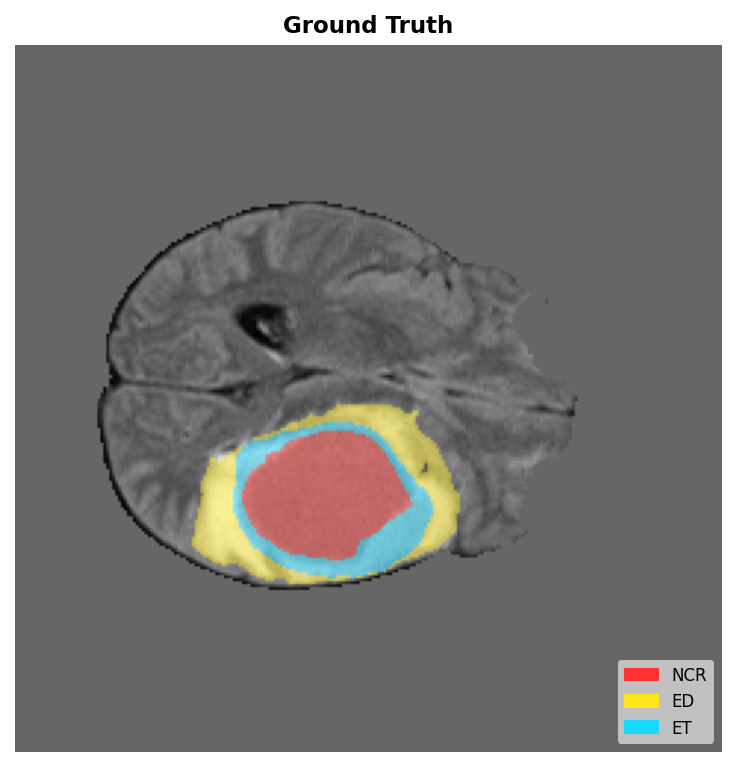
Faites glisser la poignée pour comparer la vérité terrain (à gauche) et la prédiction de l’Attention U-Net (à droite) sur le cas BraTS2021_01619, coupe axiale 67 (un cas de validation où les trois régions tumorales sont bien représentées).
Exploration des architectures
Plutôt que de choisir une seule architecture et de l’optimiser, j’ai conçu ce projet comme une progression. Chaque modèle a été choisi pour répondre à une question précise soulevée par les résultats du précédent. L’histoire va du local au global, puis revient en arrière.
Les skip connections transmettent toutes les features de l'encodeur directement au décodeur, y compris les régions de fond qui n'ont rien à voir avec la tumeur. Le modèle n'a aucun moyen de les filtrer, ce qui le pousse à sur-prédire.
Les portes d'attention aident le modèle à se concentrer sur les régions pertinentes dans les skip connections. Mais chaque convolution ne regarde toujours qu'un petit voisinage de voxels à la fois, donc le modèle ne peut pas raisonner sur la forme de la tumeur ou sur le contexte à l'échelle du cerveau entier.
Le Transformer a 62 millions de paramètres mais seulement 150 cas d'entraînement pour apprendre. Avec un tel ratio, il finit par mémoriser les patches d'entraînement au lieu de généraliser, et fait moins bien que le CNN, pourtant bien plus petit.
Ce modèle change plusieurs choses à la fois par rapport à la référence, avec moins de convolutions par niveau, un bottleneck plus léger et des activations KAN. S'il se comporte différemment, impossible de savoir proprement quel changement en est responsable.
3D U-Net (modèle 1, CNN de référence)
Çiçek et al. 2016 — “3D U-Net: Learning Dense Volumetric Segmentation from Sparse Annotation”
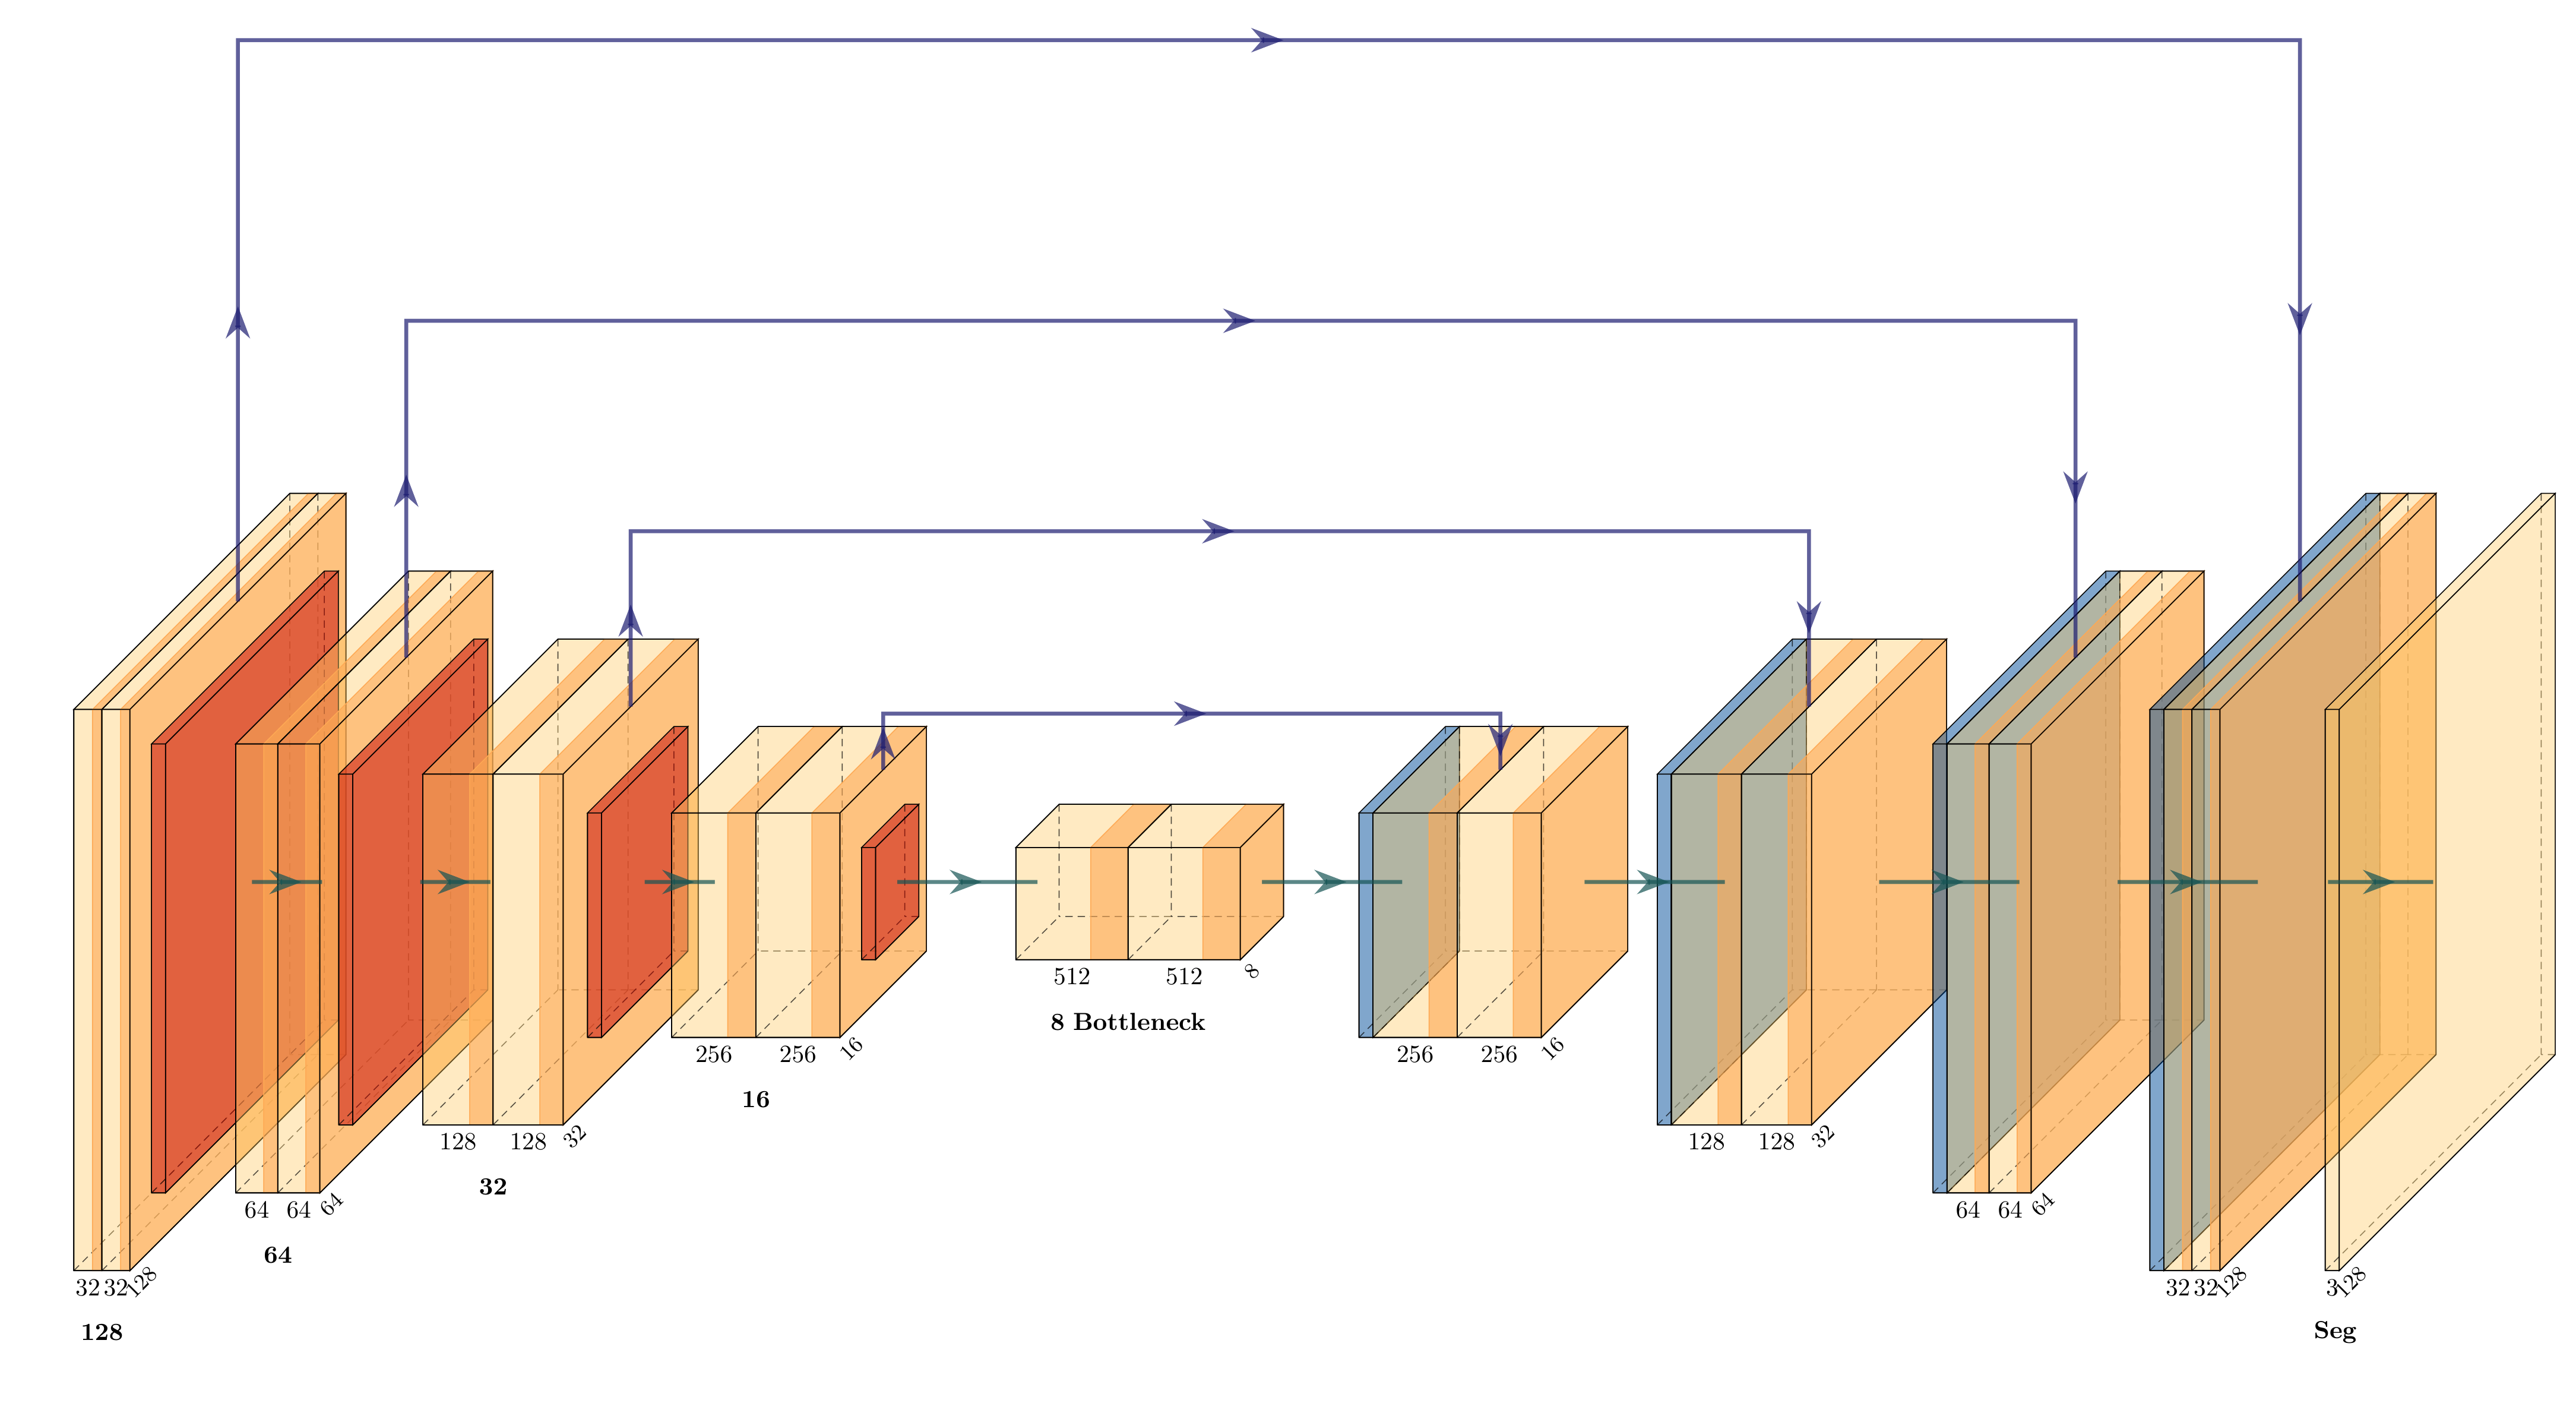
Le point de départ de presque toute tâche de segmentation médicale en 3D. Un encodeur compresse le volume sur quatre niveaux spatiaux (en divisant la résolution par deux à chaque fois par max-pooling), un bottleneck traite les features les plus abstraites, et un décodeur remonte symétriquement, avec des skip connections qui transportent le détail spatial fin de chaque niveau de l’encodeur vers le niveau correspondant du décodeur.
Construire ce modèle en premier était important pour une raison qui dépasse le score de Dice. Il met en place tout le pipeline d’entraînement dont chaque modèle suivant hérite tel quel. L’échantillonneur de patches, l’inférence par fenêtre glissante, les métriques BraTS, le suivi dans MLflow. Toutes les comparaisons se font par rapport à cette base.
Là où il atteint ses limites. Un noyau de convolution 3×3×3 voit 27 voxels voisins à la fois. C’est suffisant pour la texture locale et les contours, mais les tumeurs cérébrales ont une structure spatiale à longue portée. La forme de l’anneau de tumeur rehaussée d’un côté est liée au cœur nécrotique de l’autre. Sans empiler beaucoup de couches, le modèle ne peut pas raisonner sur cette distance. Et les skip connections transmettent tout de l’encodeur au décodeur, y compris des activations de fond qui poussent le décodeur à sur-segmenter.
| Région | WT | TC | ET | Moyenne | Entraînement |
|---|---|---|---|---|---|
| Dice | 0.876 | 0.877 | 0.869 | 0.874 | ~7 h |
Attention U-Net (modèle 2)
Oktay et al. 2018 — “Attention U-Net: Learning Where to Look for the Pancreas”
Avant d’abandonner complètement les convolutions, peut-on rendre les skip connections plus intelligentes ? L’Attention U-Net garde la même structure encodeur-décodeur mais ajoute un mécanisme de porte à chaque skip connection. Avant d’être concaténées dans le décodeur, les features de l’encodeur passent par une porte d’attention qui apprend un masque spatial doux, amplifiant les activations dans les régions qui ressemblent à de la tumeur et les atténuant dans le fond.
La porte est apprise entièrement à partir de la loss de segmentation, sans supervision supplémentaire. Le décodeur génère un signal de porte à chaque niveau de résolution et le compare aux features de l’encodeur. Là où ils concordent (ça ressemble à de la tumeur), la porte s’ouvre. Là où ils divergent, elle se ferme.
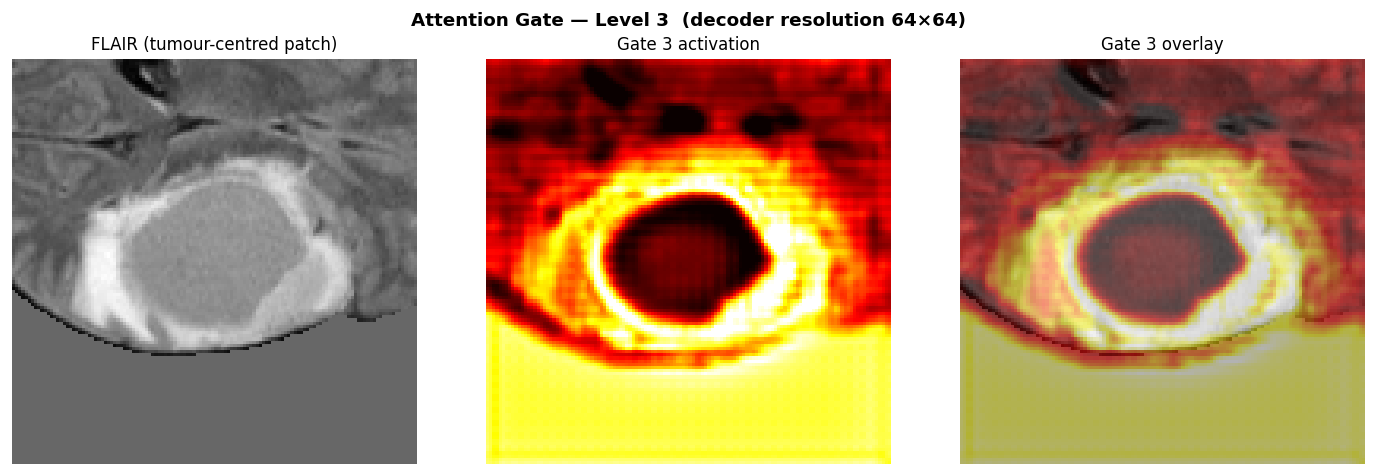
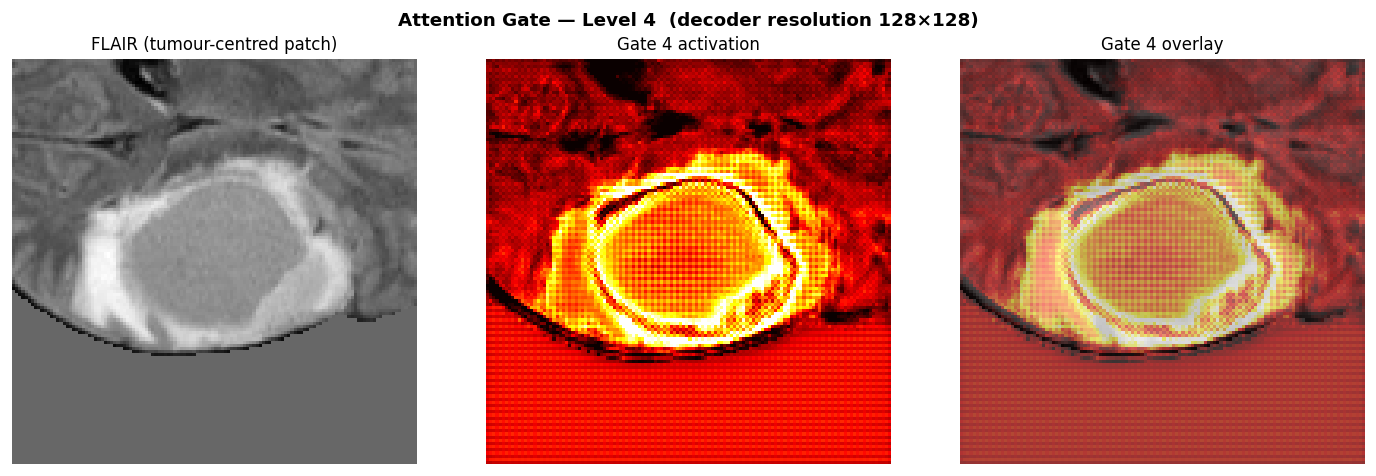
C’est ce mécanisme que l’on voit dans les cartes d’attention plus bas sur la page.
ET était la région dont j’attendais le plus de gain. Elle est compacte, a des contours irréguliers et c’est la plus difficile à distinguer des tissus voisins. Les résultats ont confirmé ce que j’attendais.
| Région | WT | TC | ET | Moyenne | Paramètres | Entraînement |
|---|---|---|---|---|---|---|
| Dice | 0.886 | 0.884 | 0.875 | 0.882 | 22.66M | ~7 h |
Comparaison avec les résultats publiés (tous entraînés sur les 1 251 cas complets) :
| WT | TC | ET | |
|---|---|---|---|
| Attention U-Net sur 150 cas | 0.886 | 0.884 | 0.875 |
| Attention U-Net publié (Oktay 2018) | 0.88–0.90 | 0.82–0.87 | 0.78–0.83 |
| Vainqueur du challenge BraTS2021 (nnU-Net) | 0.932 | 0.888 | 0.884 |
TC et ET battent tous les deux la fourchette publiée dans l’article original, avec 12 % des données. TC est à 0,004 du vainqueur du challenge BraTS2021.
Swin UNETR (modèle 3)
Hatamizadeh et al. 2022 — “Swin UNETR: Swin Transformers for Semantic Segmentation of Brain Tumors in MRI Images”
Les portes d’attention aident, mais elles opèrent toujours sur des features convolutives. La contrainte de localité est inscrite dans la convolution elle-même, pas seulement dans les skip connections. La question suivante est donc naturelle. Que se passe-t-il si l’on remplace les convolutions par un mécanisme sans aucune contrainte de localité ?
C’est exactement ce que fait Swin UNETR. Il découpe le volume 3D en petits patches (des tokens) et les fait passer dans un encodeur Swin Transformer hiérarchique, où chaque token porte son attention sur tous les autres tokens de sa fenêtre locale, et où ces fenêtres se décalent d’une couche à l’autre pour laisser le contexte global s’accumuler. Un voxel à l’avant du cerveau peut, en principe, influencer directement les prédictions à l’arrière. Le décodeur reste basé sur des CNN, pour garder un chemin de suréchantillonnage efficace.
| Région | WT | TC | ET | Moyenne | Paramètres | Entraînement |
|---|---|---|---|---|---|---|
| Dice | 0.882 | 0.863 | 0.862 | 0.869 | 62.19M | ~17 h |
Swin UNETR a perdu face à l’Attention U-Net (0,869 contre 0,882 de Dice moyen) malgré 2,7× plus de paramètres et environ 17 heures d’entraînement.
C’est le résultat que j’ai trouvé le plus intéressant, et honnêtement celui que je n’avais pas prévu. Je m’attendais à ce que le Transformer égale au moins le CNN en évaluation sur volume complet, puisqu’il faisait clairement mieux au niveau des patches (0,855 contre 0,834). Ce n’est pas arrivé. Avec le recul, trois choses se sont additionnées. Soixante-deux millions de paramètres pour 150 cas, c’est un mauvais rapport dès le départ (l’écart entre la validation par patches et l’évaluation sur volume complet est le signe classique d’un modèle qui mémorise des motifs de patches au lieu de généraliser). Ensuite, l’entraînement par patches a sapé précisément ce qui devait justifier le coût de Swin UNETR. Il a été entraîné sur des découpes de 128³ et n’a jamais vu un cerveau entier, donc le mécanisme d’attention conçu pour le contexte global n’a jamais eu de contexte global à exploiter. Enfin, les CNN ont un a priori de localité spatiale intégré qui s’avère être une hypothèse utile pour les images médicales, et qui généralise bien à partir de peu d’exemples, ce que les Transformers, qui apprennent la structure spatiale de zéro, ne font tout simplement pas.
Plus de paramètres et une attention globale ne garantissent pas de meilleurs résultats. Avec peu de données, un CNN bien conçu avec une attention ciblée bat un Transformer 4× plus gros.
KAN U-Net (modèle 4, 3D U-KABS)
Liu et al. 2024 — “KAN: Kolmogorov-Arnold Networks” (ICLR 2025)
arXiv:2602.07702 — “A hybrid Kolmogorov-Arnold network for medical image segmentation”
Le résultat de Swin UNETR change toute la question. Si un modèle plus gros et plus puissant a échoué parce qu’il avait trop de paramètres pour les données disponibles, que se passe-t-il si l’on va dans la direction opposée ? Jusqu’où peut-on réduire le modèle avant que les performances s’effondrent ?
Au départ, le plan était d’implémenter CDA-Mamba ici (un modèle à espace d’états récent qui semblait être le successeur naturel de Swin UNETR, en remplaçant le coût quadratique de l’attention du Transformer par un balayage linéaire). Je me suis heurté à un mur. mamba-ssm n’a pas de wheels Windows officielles, et le compiler depuis les sources avec la bonne version de CUDA n’était pas l’affaire d’un après-midi. Plutôt que de passer des jours à me battre avec l’environnement, je suis passé à KAN U-Net, un article de 2026, lui aussi récent et peu conventionnel, et en pur PyTorch sans dépendances exotiques. Avec le recul, ce changement de cap a été une bonne chose, car le résultat KAN s’est révélé le plus intéressant de tout le projet.
KAN U-Net est l’expérience qui teste la piste légère. C’est une ossature 3D U-Net où les activations standard des deux niveaux spatiaux les plus profonds sont remplacées par des activations KAN (Kolmogorov-Arnold Network), des fonctions splines apprenables plutôt que des non-linéarités fixes. Le reste de l’architecture reste mince, avec une seule convolution par niveau, un bottleneck séparable en profondeur et une attention par canal de type squeeze-and-excitation. Le nombre total de paramètres est de 2,42M.
L’idée clé des KAN, c’est que dans un réseau classique, les poids sont apprenables mais les fonctions d’activation (ReLU, GELU) ont une forme fixe. Les KAN inversent la logique. Ce sont les activations elles-mêmes qui deviennent des courbes apprenables qui s’adaptent pendant l’entraînement. La base théorique est le théorème de représentation de Kolmogorov-Arnold, selon lequel toute fonction continue peut se décomposer en compositions de fonctions plus simples à une seule variable.
Deux types de courbes sont utilisés par bloc. L’un utilise des courbes globales lisses, adaptées à la forme générale de la tumeur, appelées KAB (polynômes de Bernstein). L’autre utilise des courbes à adaptation locale, mieux adaptées au détail fin des contours, appelées KAS (B-splines).
| Région | WT | TC | ET | Moyenne | Paramètres | Entraînement |
|---|---|---|---|---|---|---|
| Dice | 0.878 | 0.873 | 0.856 | 0.869 | 2.42M | ~7 h |
KAN U-Net égale le Dice moyen de Swin UNETR (0,869) avec 26× moins de paramètres. Le Transformer avait besoin de 62 millions de paramètres et de 17 heures d’entraînement. Celui-ci y est arrivé avec 2,42 millions, en une fraction du temps.
KAN 3D U-Net (modèle 5, ablation)
Une chose me travaillait. L’architecture U-KABS (KAN U-Net) diffère du 3D U-Net par bien plus que ses activations. Elle utilise aussi une seule convolution par niveau, un bottleneck en profondeur et une attention par canal SE. Donc même si U-KABS fonctionne bien, on ne peut pas attribuer proprement ce résultat aux activations KAN. Pour trancher, j’ai mené une ablation contrôlée sur exactement la même architecture 3D U-Net, avec pour seul changement le remplacement des deux activations LeakyReLU du bottleneck par des activations KAN (Bernstein + B-spline). Chaque bloc de l’encodeur, chaque bloc du décodeur, chaque skip connection reste inchangé. Seule la fonction d’activation du bottleneck diffère.
On obtient ainsi une ablation propre, une seule variable modifiée et tout le reste identique.
| Région | WT | TC | ET | Moyenne | Paramètres | Entraînement |
|---|---|---|---|---|---|---|
| Dice | 0.879 | 0.885 | 0.869 | 0.878 | 22.59M | ~7 h |
Le score TC de 0,885 bat de peu l’Attention U-Net (0,884), le modèle précisément conçu pour améliorer TC grâce à ses portes apprises. Il me faudrait plusieurs graines pour être sûr que l’amélioration moyenne de 0,004 est un vrai signal et pas du bruit, mais la tendance est constante. Ce qui est clair, c’est que des activations KAN au bottleneck ne font pas de mal, et pourraient apporter un léger gain à la couche la plus complexe sémantiquement du réseau.
Synthèse des résultats
Trié par Dice moyen (décroissant). Tous les modèles : GTX 1070 Ti, 150 cas d’entraînement sur 1 251, pipeline identique.
| Modèle | WT | TC | ET | Moyenne | Paramètres | Entraînement | Remarques |
|---|---|---|---|---|---|---|---|
| Attention U-Net | 0.886 | 0.884 | 0.875 | 0.882 | 22.66M | ~7 h | Meilleur au global, TC et ET battent les résultats publiés sur données complètes |
| KAN 3D U-Net | 0.879 | 0.885 | 0.869 | 0.878 | 22.59M | ~7 h | Ablation, KAN au bottleneck uniquement, TC bat l'Attention U-Net |
| 3D U-Net | 0.876 | 0.877 | 0.869 | 0.874 | 22.58M | ~7 h | Référence |
| Swin UNETR | 0.882 | 0.863 | 0.862 | 0.869 | 62.19M | ~17 h | Battu par un CNN malgré 2,7× plus de paramètres |
| KAN U-Net | 0.878 | 0.873 | 0.856 | 0.869 | 2.42M | ~7 h | Égale le Transformer avec 26× moins de paramètres |
Tous les modèles ont été entraînés sur les mêmes 150 cas sur 1 251, sur une GTX 1070 Ti, avec des pipelines d’entraînement identiques. Ce sont les comparaisons entre architectures qui comptent ici. Les scores absolus sont en dessous des résultats publiés sur le jeu complet, mais c’est une question de volume de données, pas d’architecture.
Comparer deux modèles au choix
Choisissez les prédictions à placer de chaque côté du séparateur, puis faites glisser la ligne pour révéler l’une sous l’autre.
Faites glisser le séparateur pour révéler une prédiction sous l'autre. Cas BraTS2021_01619, coupe axiale 67.
Maillage 3D de la tumeur
Le masque de segmentation n’est pas qu’un contour 2D. C’est un volume 3D complet. En appliquant Marching Cubes à l’annotation de référence, chaque sous-région devient un maillage de surface triangulé. La coque grise translucide est la surface du cerveau lui-même, extraite de l’image FLAIR sans le crâne, pour donner une idée de l’emplacement anatomique de la tumeur et de sa taille par rapport aux tissus qui l’entourent.
Glissez pour faire pivoter, molette pour zoomer. Cliquez sur les éléments de la légende pour afficher ou masquer les régions.
Vérité terrain du cas BraTS2021_01619, rendue avec Marching Cubes. Surface du cerveau (pas de 5, 7k sommets) · NCR en rouge (3,9k sommets) · ED en jaune (10,2k sommets) · ET en cyan (7,8k sommets).
Cartes d’activation des portes d’attention
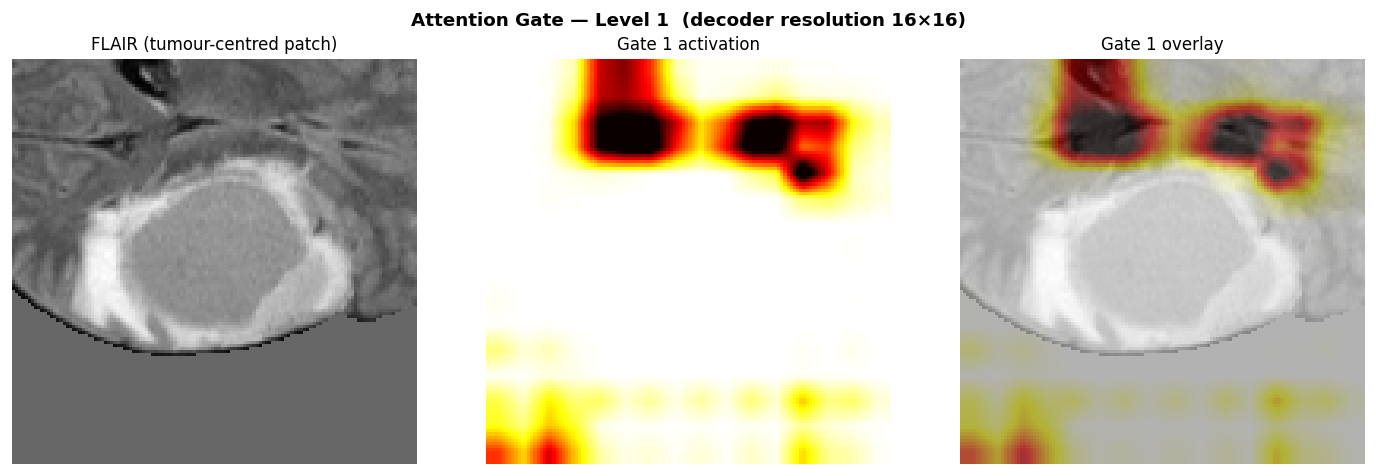
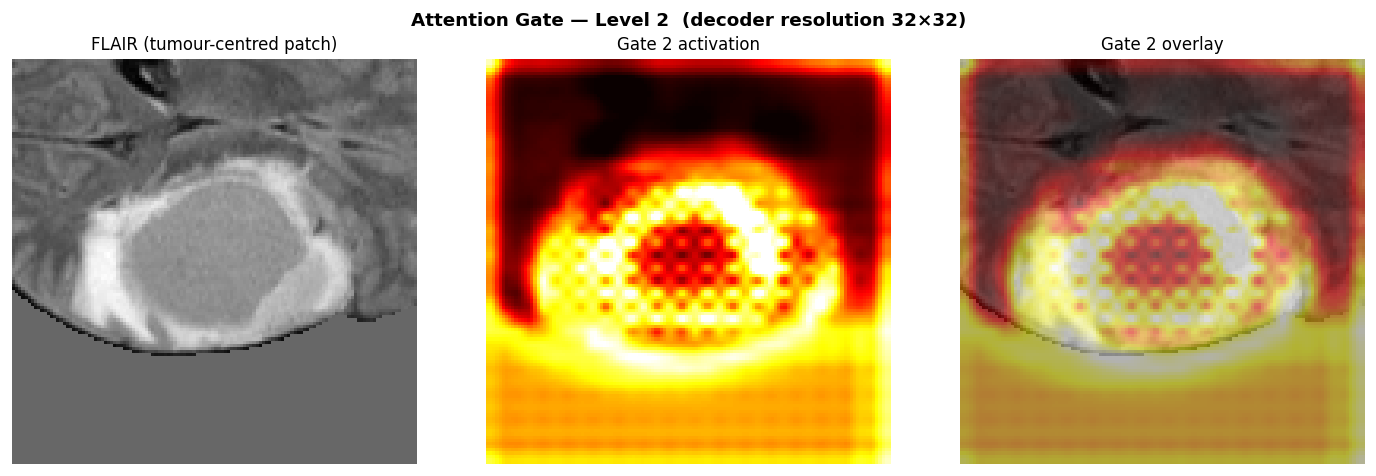
L’un des avantages de l’Attention U-Net, c’est qu’il produit des sorties interprétables au-delà du masque de segmentation. Les portes d’attention génèrent une carte de poids spatiale à chaque niveau du décodeur. Des valeurs proches de 1 signifient que la porte est ouverte (ces features de l’encodeur passent), des valeurs proches de 0 qu’elles sont atténuées. Les zones claires sont celles sur lesquelles le modèle se concentre.
Elles ont été extraites en enregistrant des forward hooks sur chaque module AttentionGate3d pendant une seule passe avant sur un patch de 128³ centré sur la tumeur. Chaque image montre trois panneaux, la découpe FLAIR brute (à gauche), la carte d’activation de la porte (au centre) et la porte superposée à la FLAIR (à droite). Les trois panneaux sont alignés spatialement sur le même patch.
Carte d’incertitude (augmentation au moment du test)
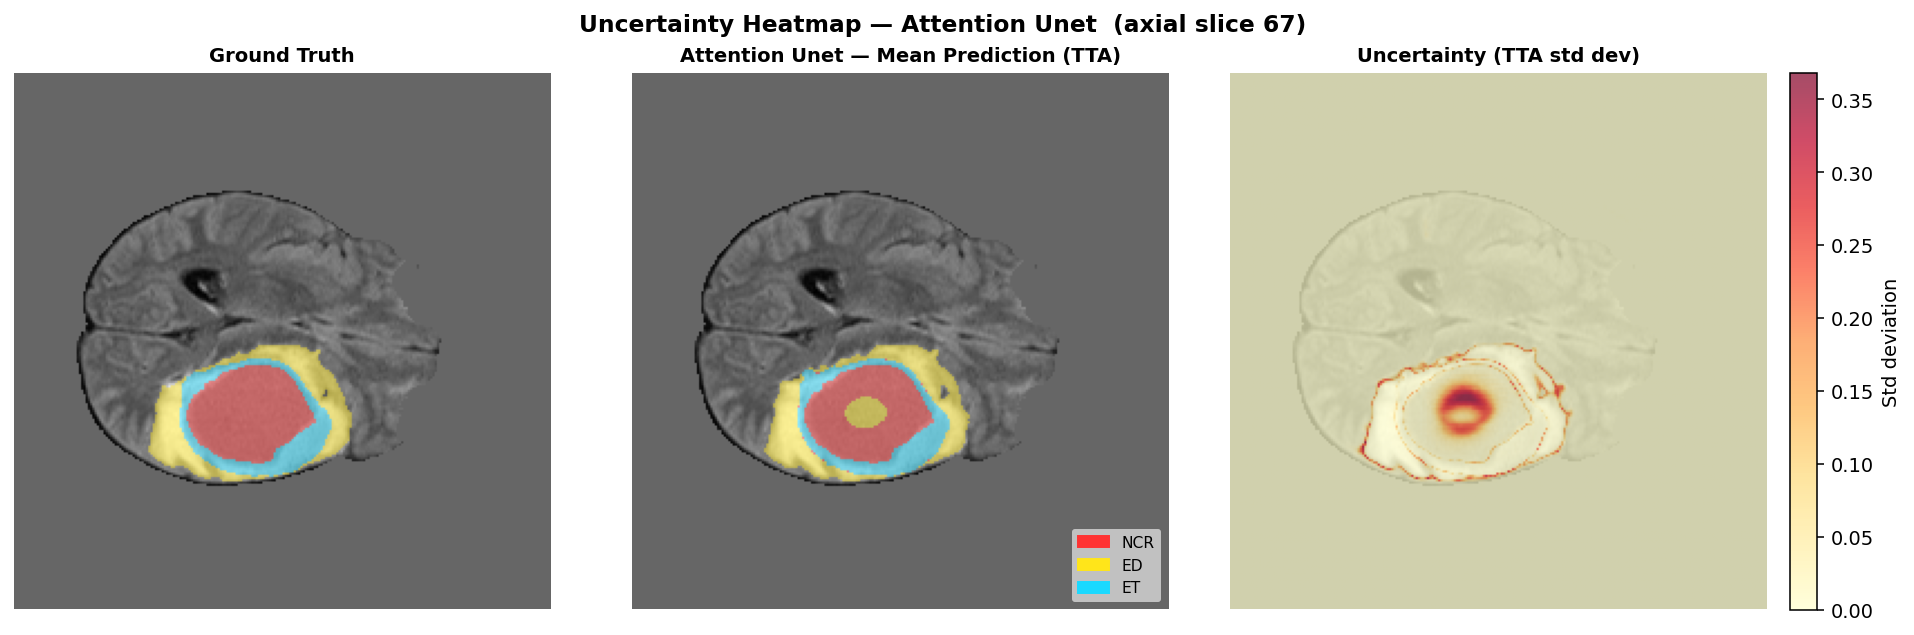
Savoir où le modèle est confiant compte autant que la prédiction elle-même. Les cartes ci-dessous ont été produites avec l’Attention U-Net, le meilleur modèle de cette comparaison. Pour obtenir une estimation de confiance par voxel sans changer l’architecture, j’ai lancé l’inférence 8 fois, chaque fois avec une combinaison différente de retournements d’axes appliqués à l’entrée puis annulés sur la sortie. La moyenne de ces 8 prédictions donne un masque final plus robuste, et l’écart-type par voxel donne une carte d’incertitude.
L’intuition est simple. Si le modèle donne la même réponse quelle que soit l’orientation du cerveau, il est confiant. Si la réponse change avec l’orientation, quelque chose est ambigu à cet endroit.
L’incertitude élevée (jaune-rouge vif) se concentre aux bords de la tumeur, exactement là où un radiologue voudrait vérifier deux fois. La transition NCR/ED, où le cœur nécrotique rencontre l’œdème environnant, est systématiquement la région la plus incertaine d’un patient à l’autre.
Graphiques interactifs
Comparaison des modèles
Graphique radar
Efficacité en paramètres
Courbes d’entraînement
Les courbes de Dice de validation sautent pas mal, et cela mérite une explication. Chaque passe de validation pendant l’entraînement tourne sur des patches aléatoires de 128³ (pas sur le cerveau entier). Avec seulement 50 cas de validation, une époque donnée peut tomber sur plus de régions de fond, ou au contraire attraper le bord de la tumeur rehaussée sur chaque cas, ce qui fait bouger le Dice global de quelques points dans un sens ou dans l’autre. C’est du bruit d’échantillonnage, pas de l’instabilité. Les chiffres finaux des tableaux de résultats sont une autre histoire. Ils viennent d’une inférence par fenêtre glissante sur le volume entier, qui lisse tout cela, et c’est pourquoi les scores rapportés sont à la fois plus stables et un peu plus élevés que ce que suggèrent les courbes en cours d’entraînement.
Schémas d’architecture
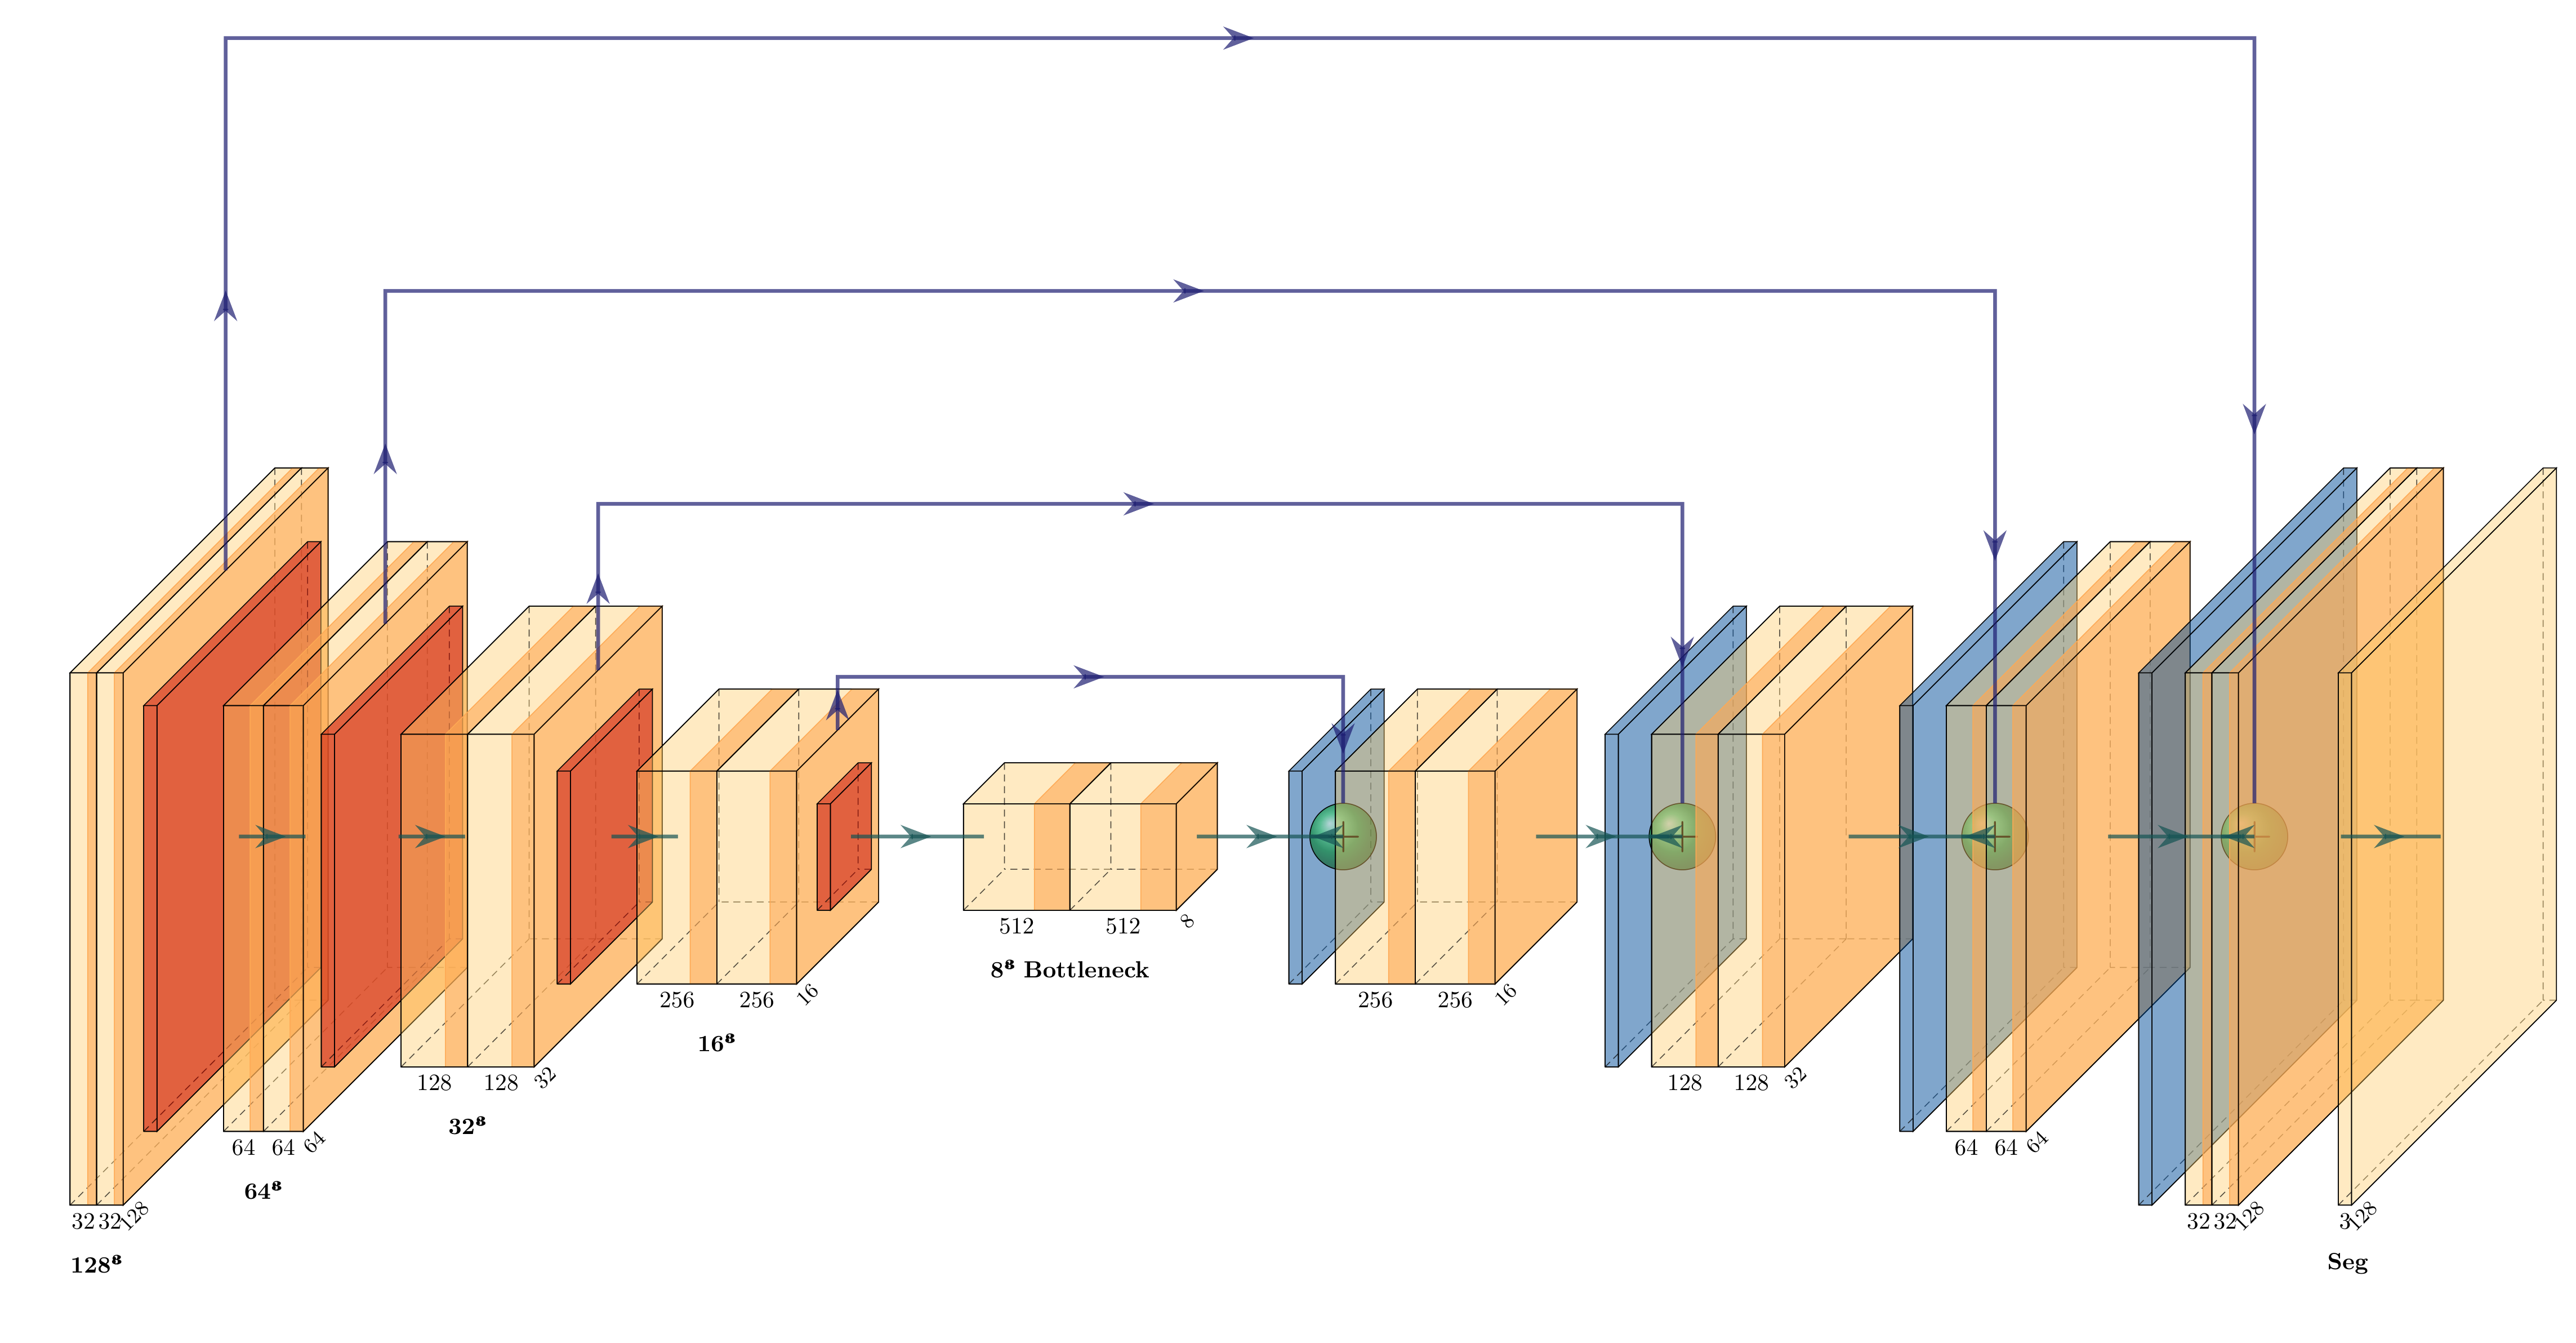
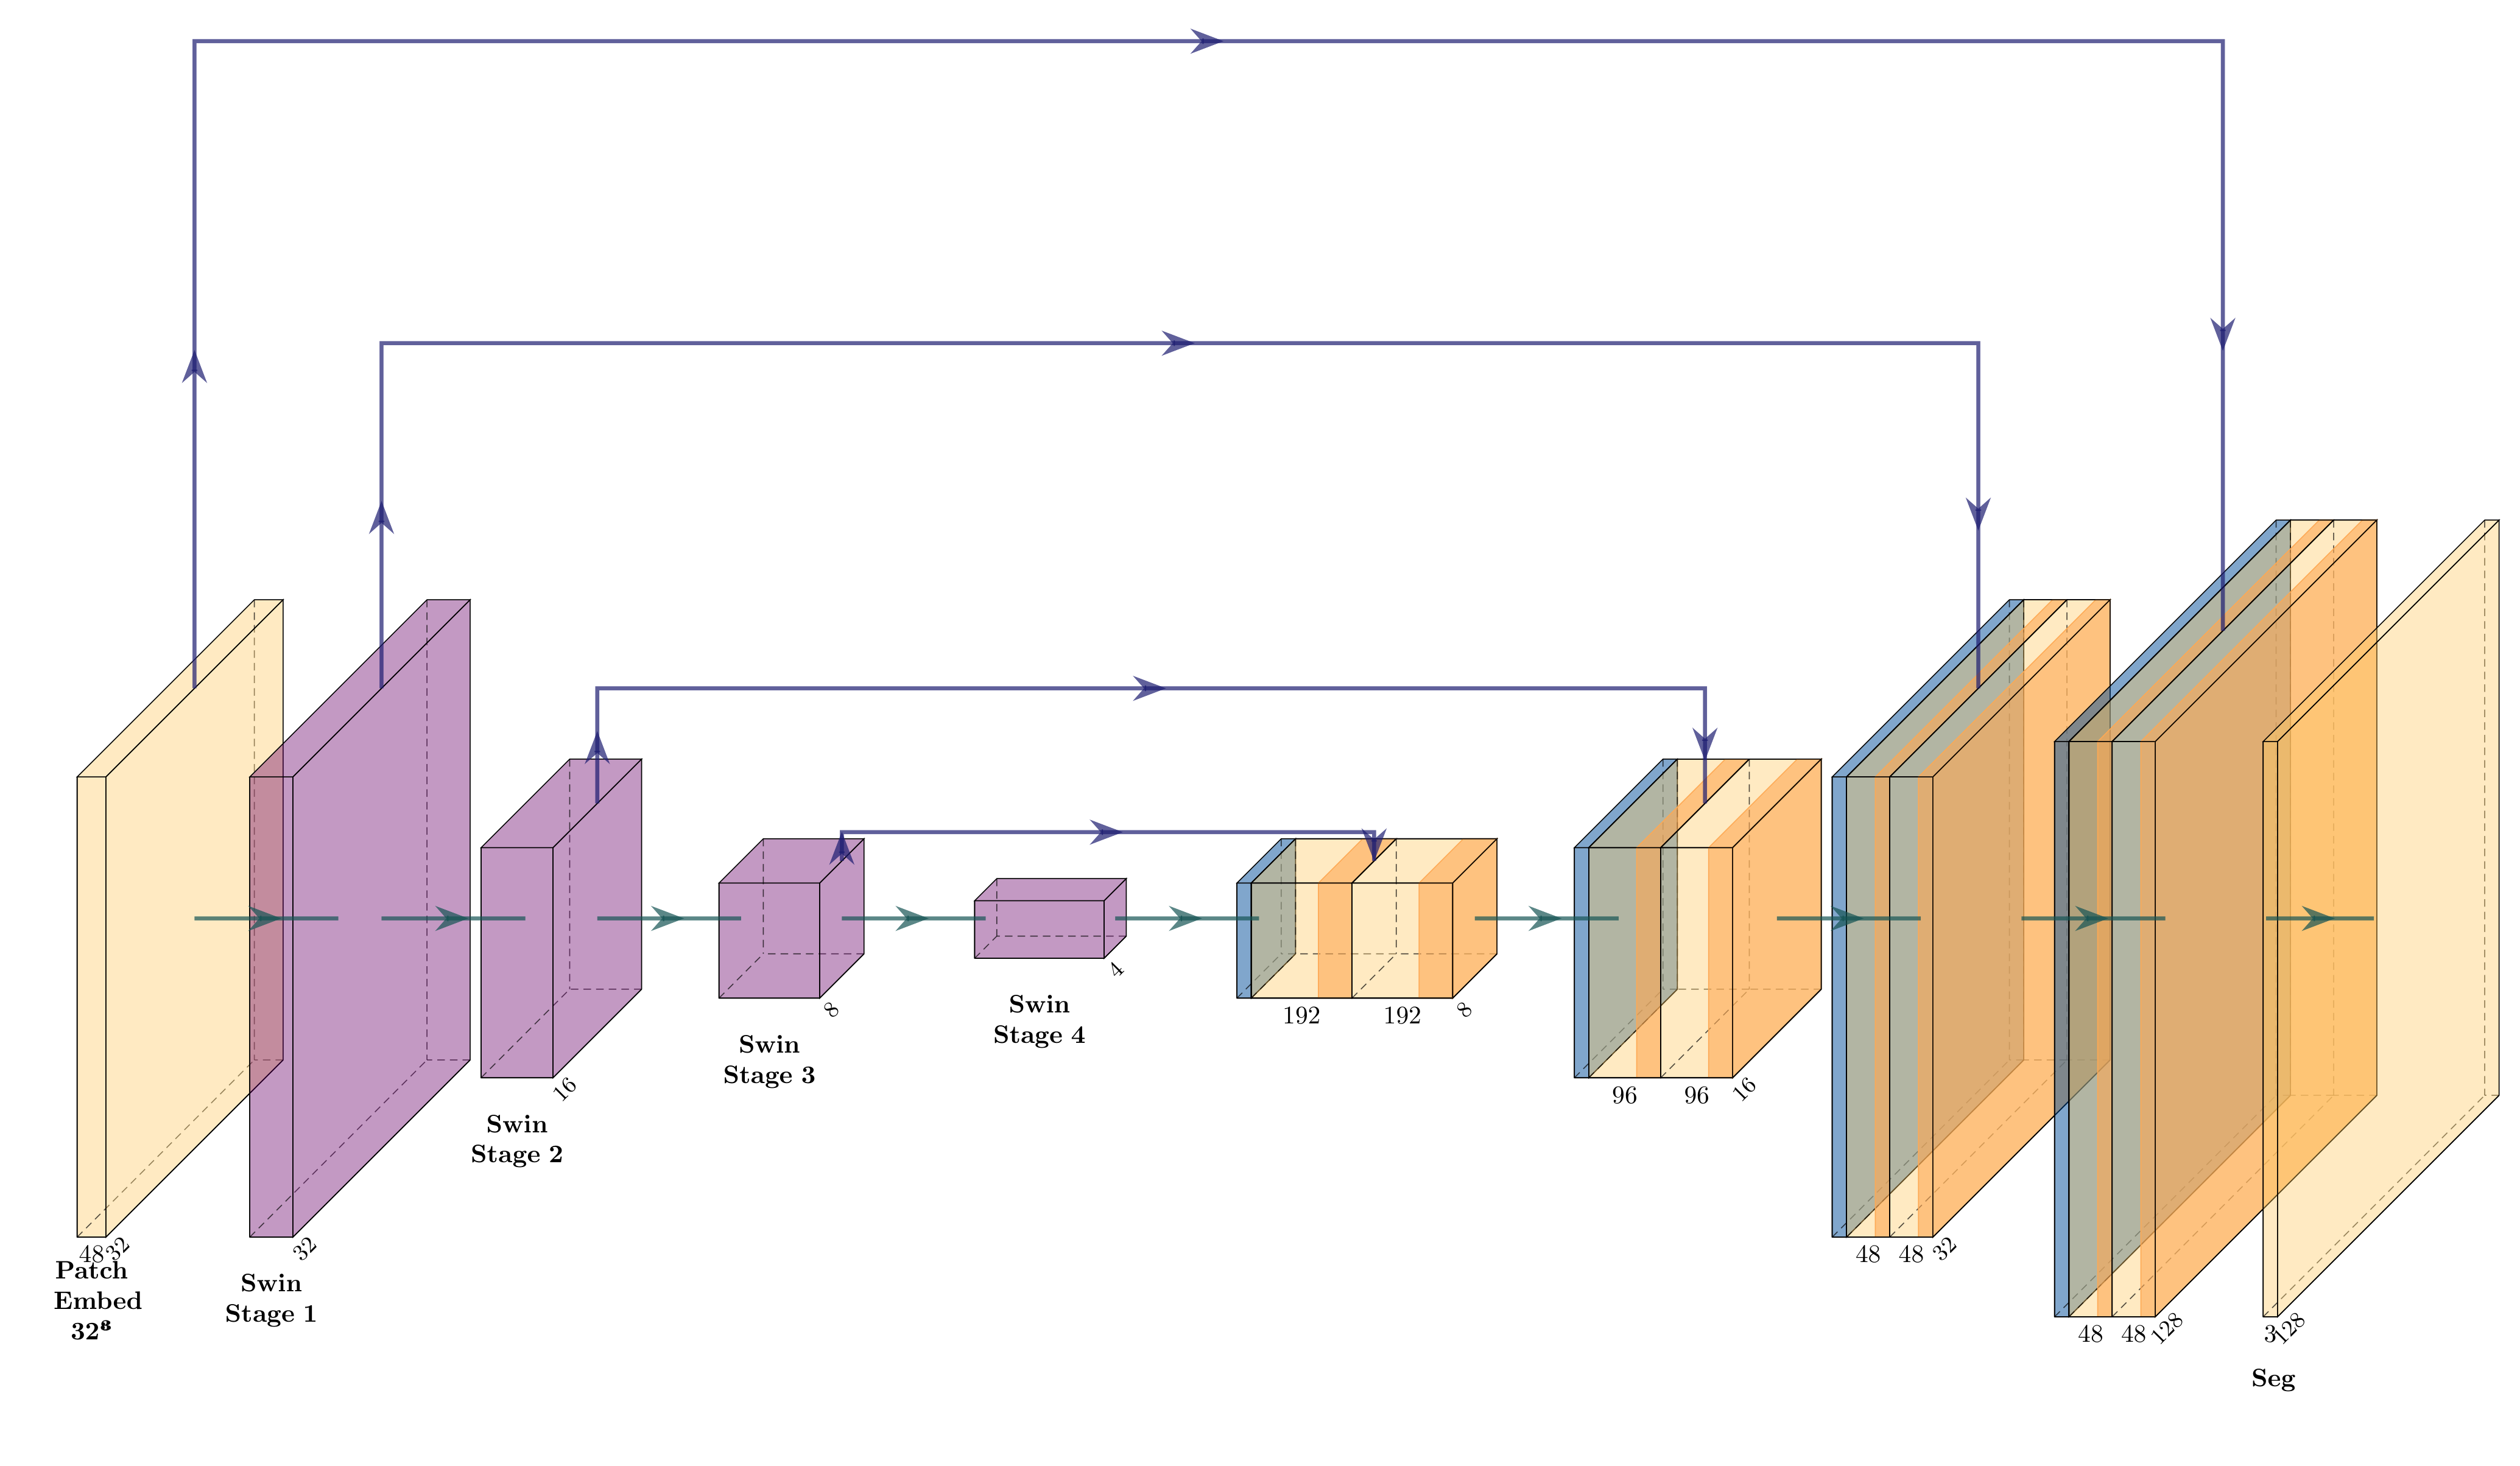
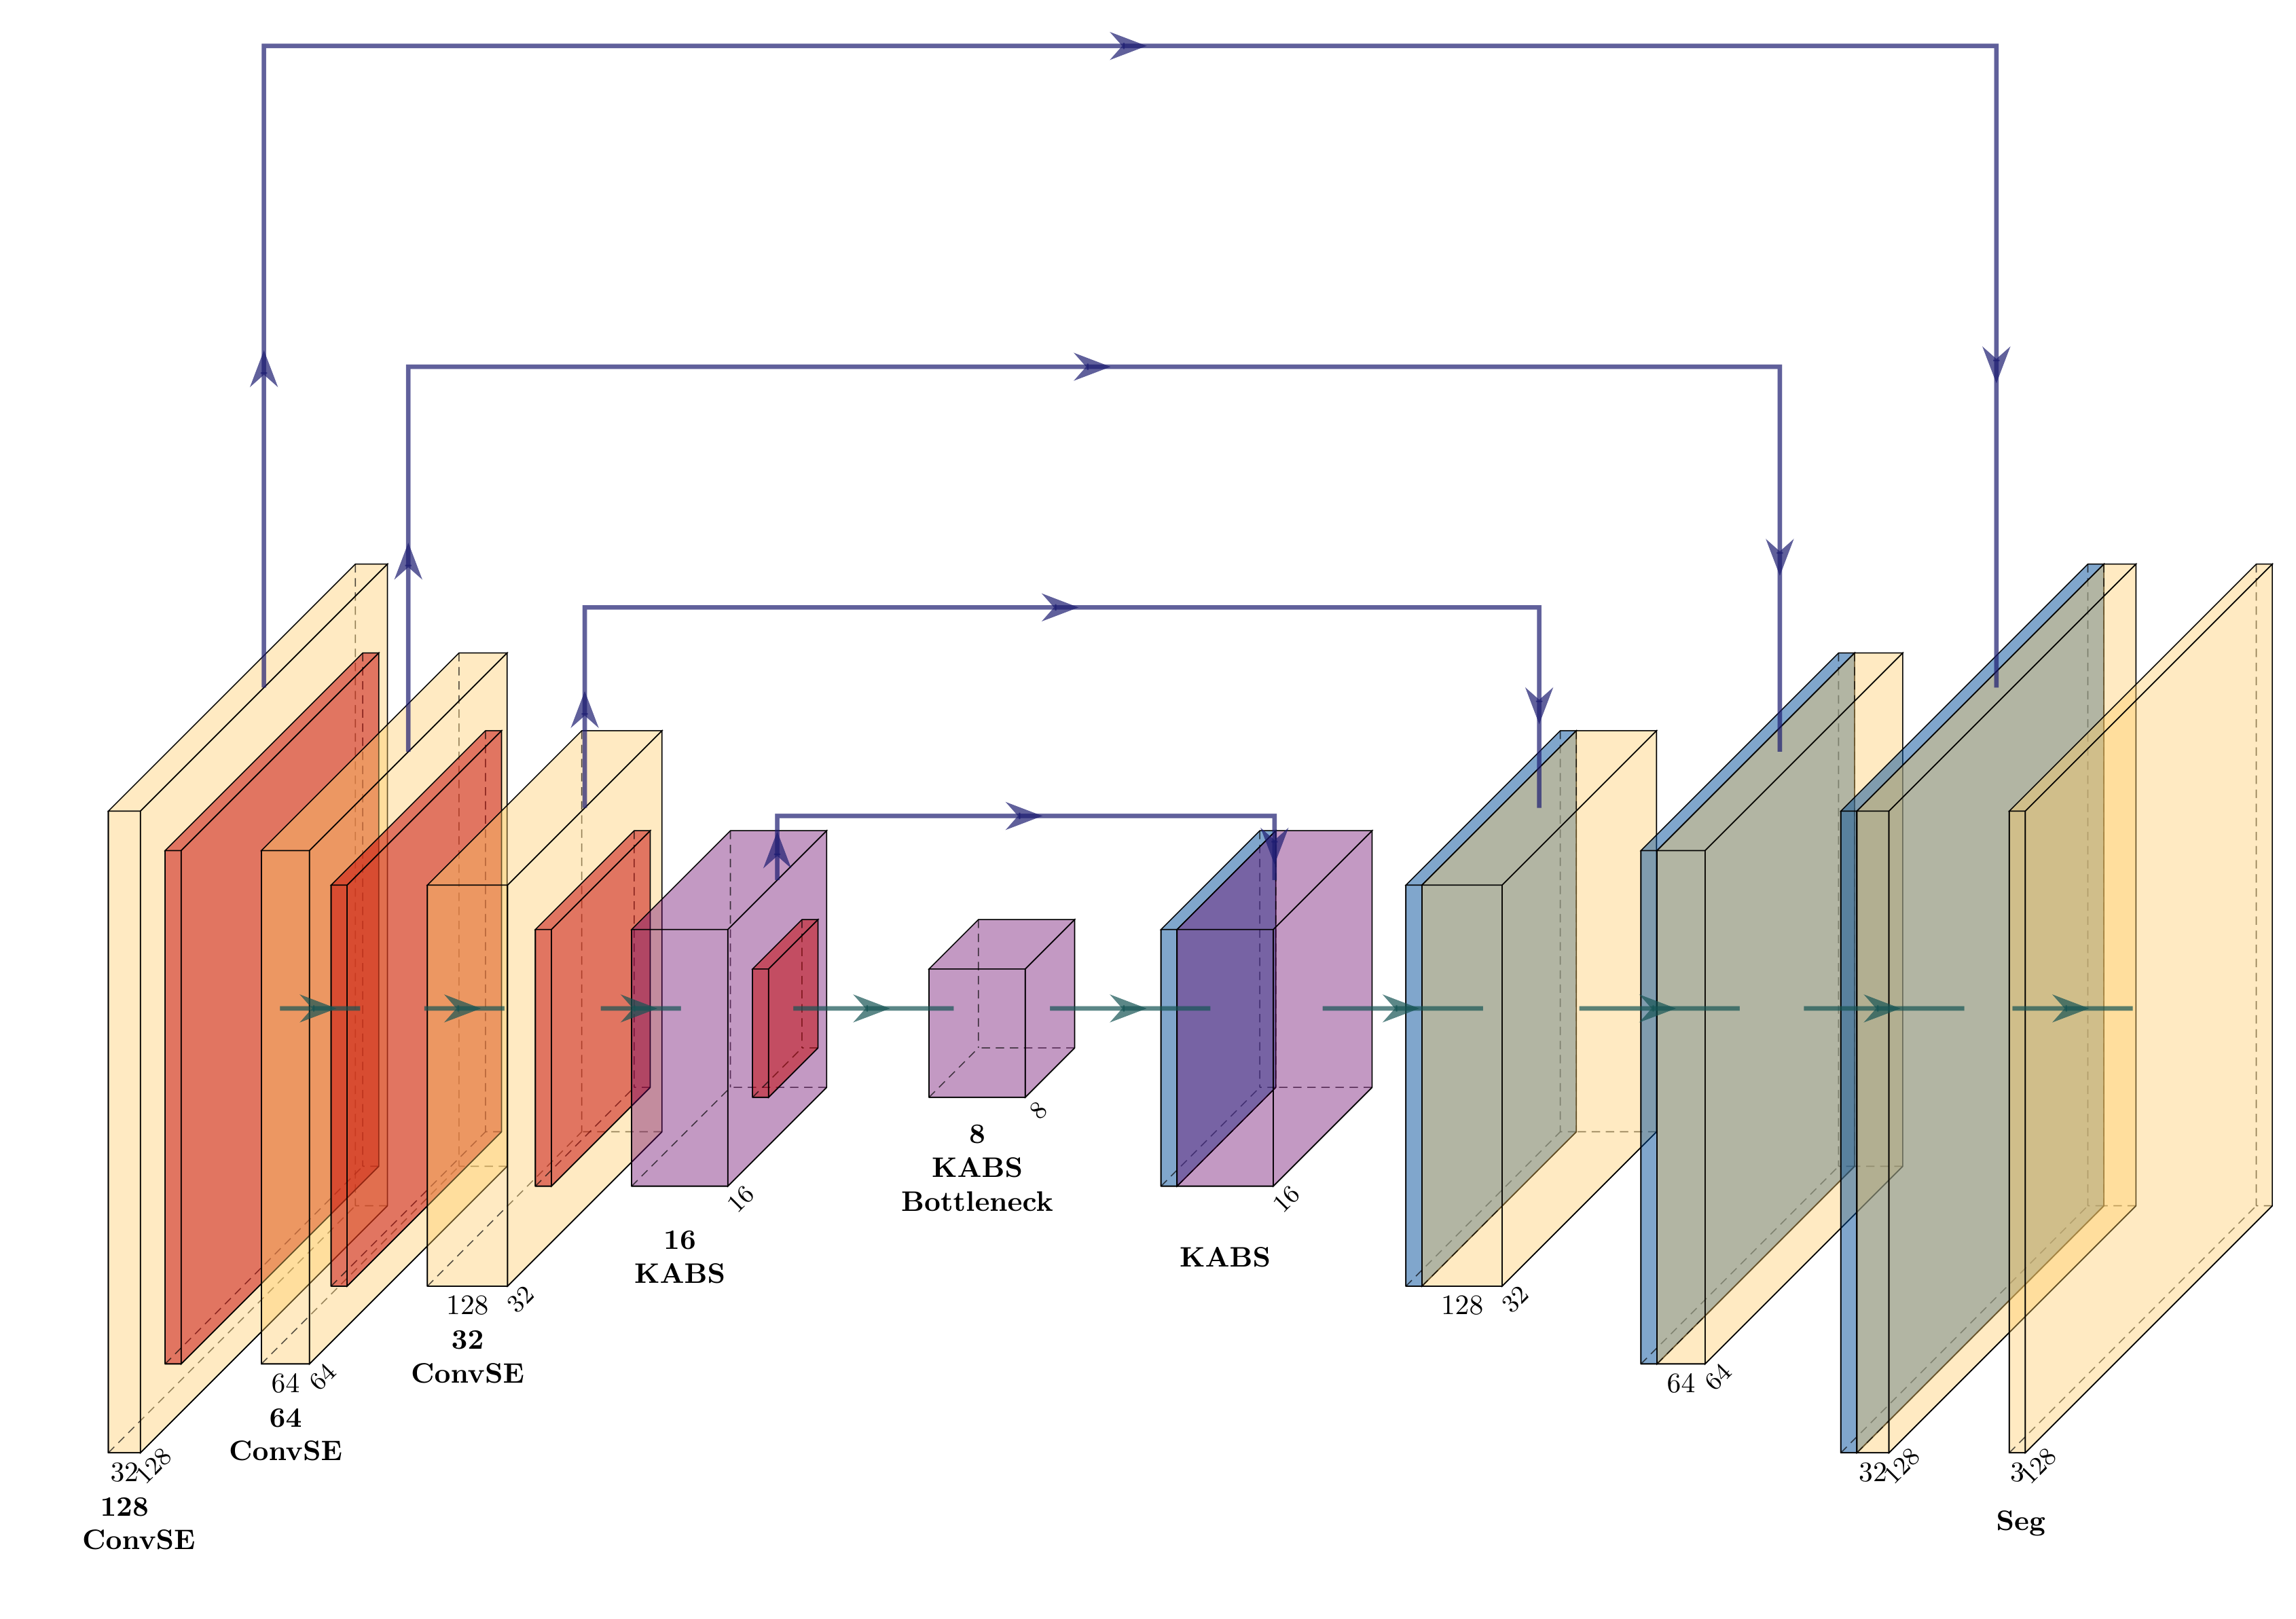
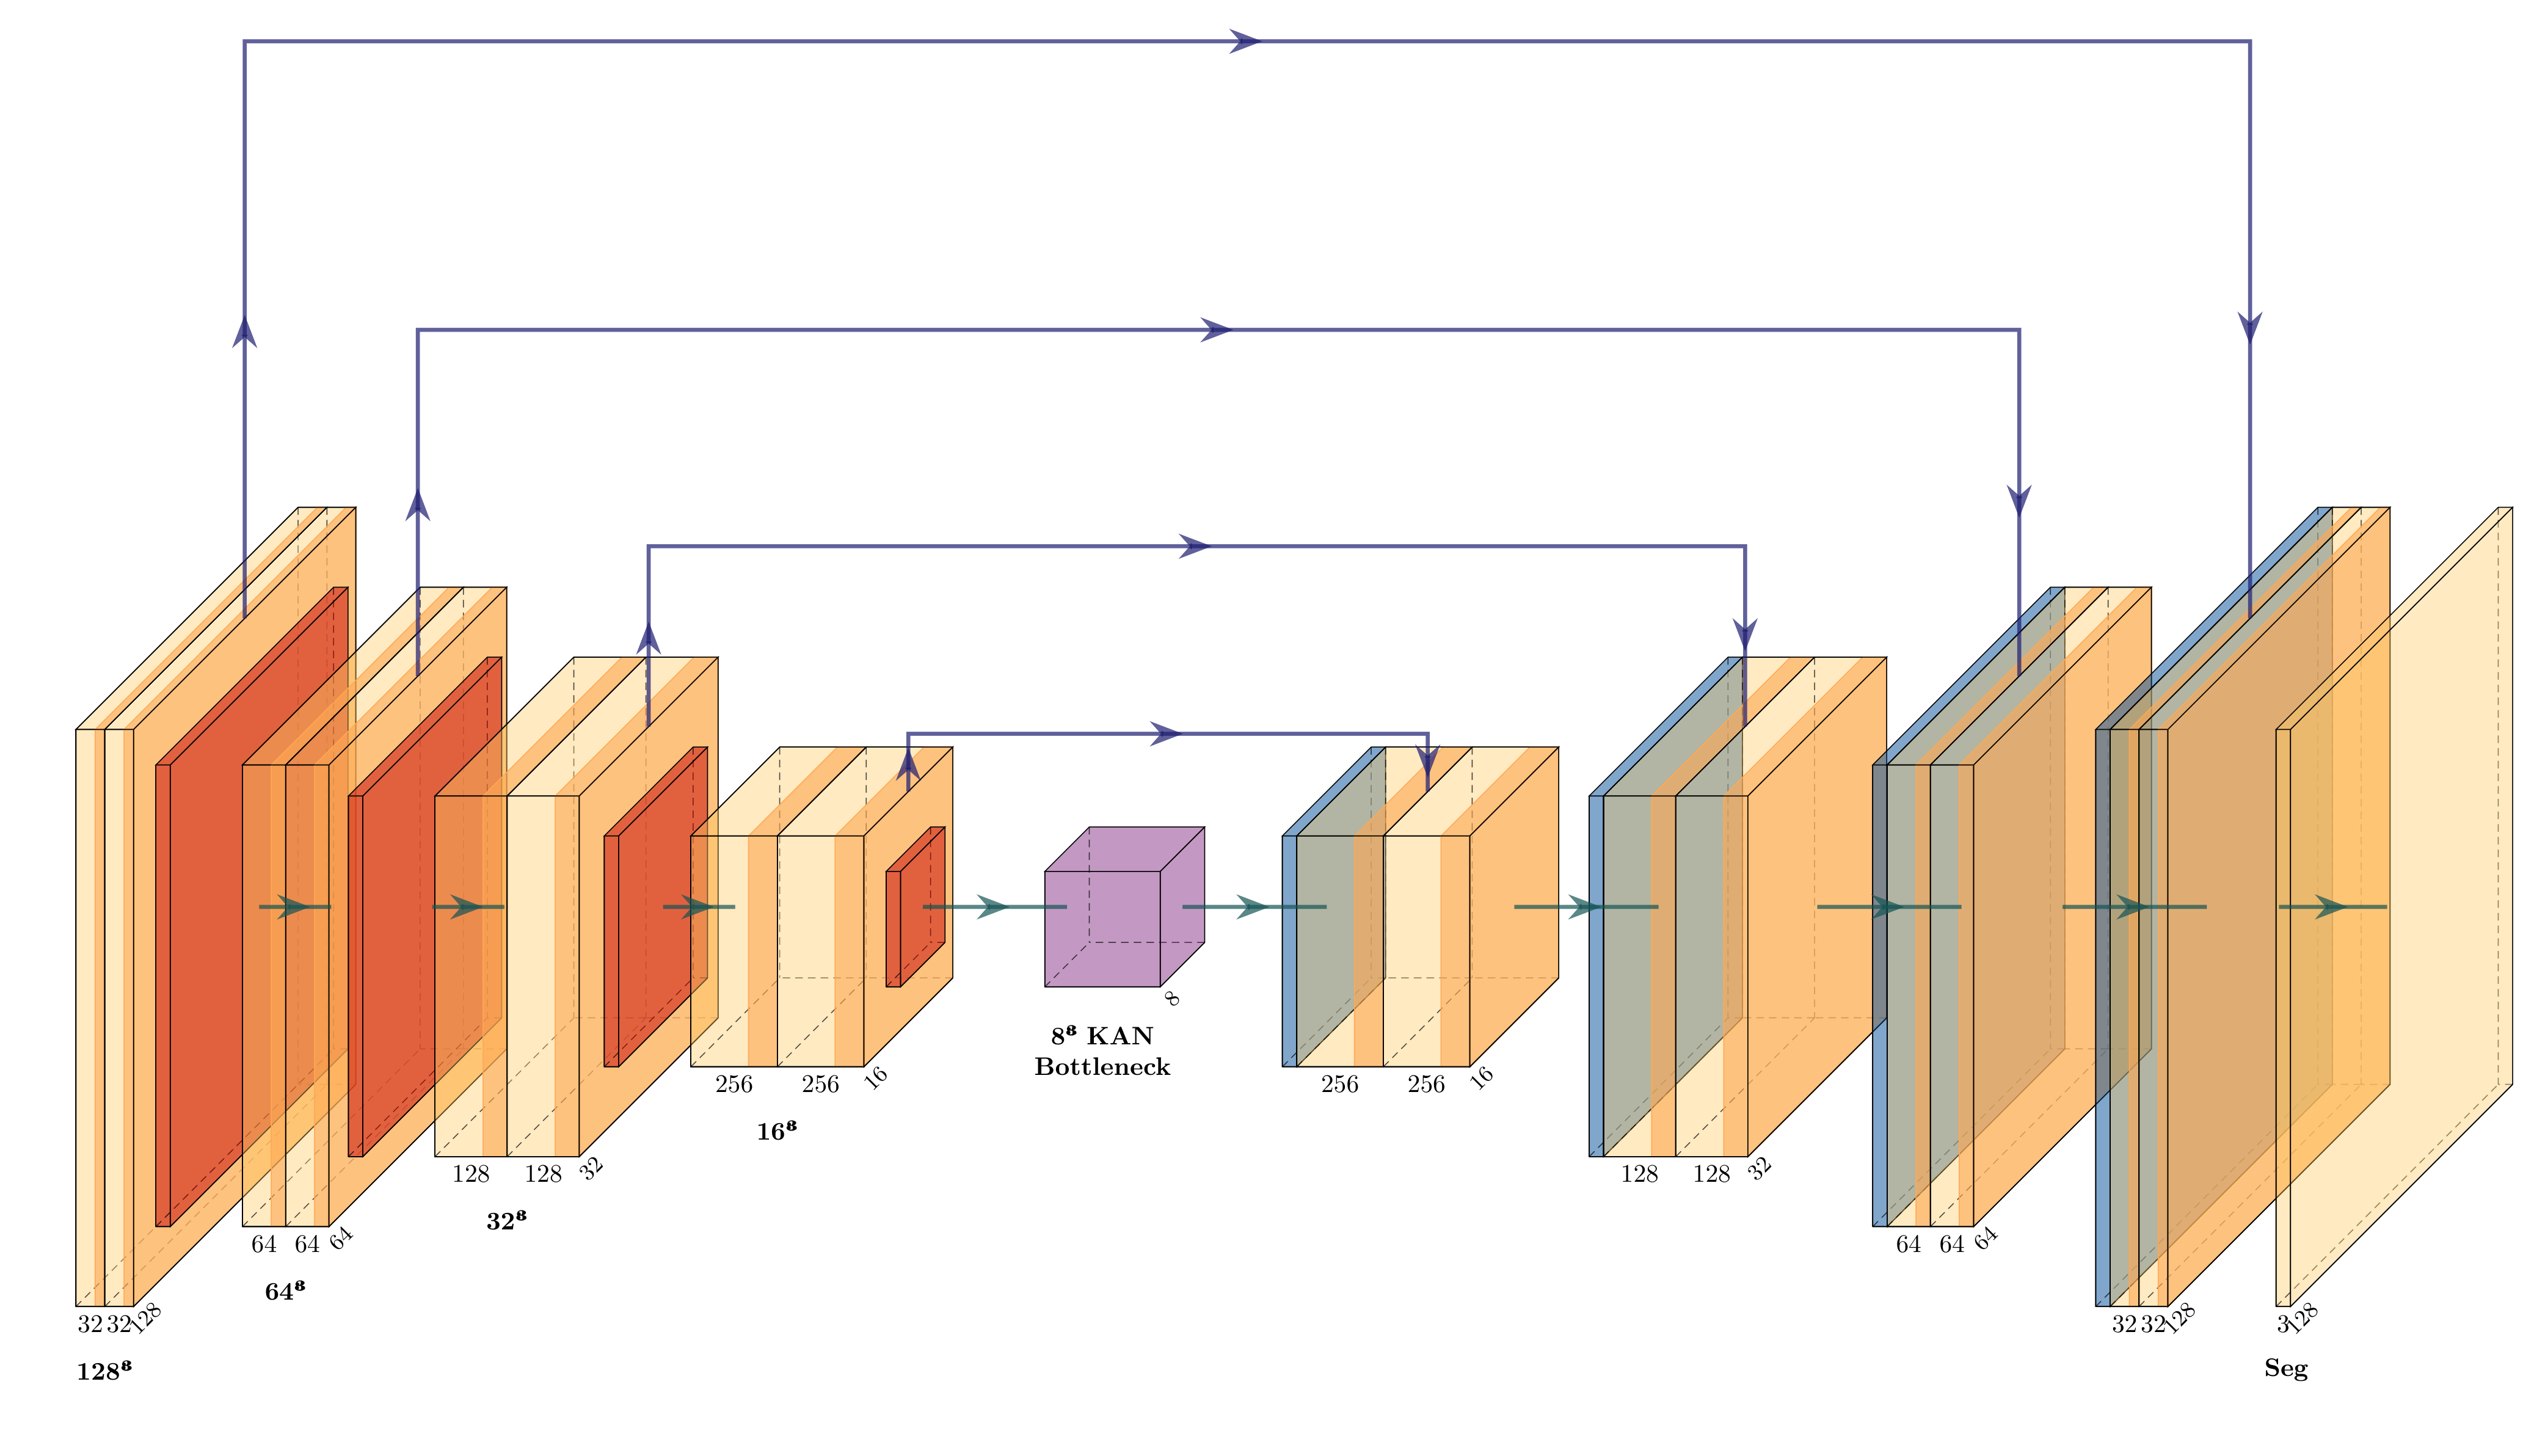
Choix d’ingénierie
Quelques décisions qui ont façonné le déroulement du projet. Certaines étaient plutôt évidentes, d’autres moins.
Cache de pré-traitement en npy
Charger du NIfTI avec nibabel est environ 100× plus lent que charger un tableau numpy. Comme chaque entraînement parcourt 150 cas par époque pendant 100 époques, ce surcoût s'accumule vite. Une passe de pré-traitement unique qui convertit tout en fichiers .npy en float16 fait passer le chargement des données par époque de quelques minutes à quelques millisecondes. C'est le genre de chose qui ressemble à un détail d'optimisation mais qui change vraiment ce qu'il est possible d'expérimenter.
Patches de 128³, batch de 1, fp16
Un volume BraTS complet (240×240×155 sur 4 modalités) est très loin de tenir dans 8 Go de VRAM. La solution consiste à découper au hasard des patches de 128³ avec un échantillonnage biaisé vers le premier plan, pour que le modèle voie plus souvent du tissu tumoral que du fond. Un batch de 1 et la précision mixte fp16 (torch.cuda.amp) sont tous deux nécessaires pour rester dans la VRAM. Le GradScaler gère automatiquement le sous-dépassement des gradients en fp16.
BCEDiceLoss (mélange 50/50)
La Dice loss seule est instable au début de l'entraînement. Quand toutes les prédictions sont proches de zéro à l'initialisation, le gradient s'annule presque. Y mélanger la BCE à parts égales donne un signal stable dès la première époque. Le ratio 50/50 est un point de départ classique pour BraTS et je n'ai pas trouvé de raison d'y toucher.
AdamW (lr 1e-4, weight decay 1e-5)
Dans Adam classique, le weight decay est intégré à la mise à jour du gradient, ce qui fait varier la régularisation effective d'un paramètre à l'autre selon l'amplitude de son gradient. AdamW découple les deux, et pénalise chaque paramètre proportionnellement à sa propre amplitude, indépendamment du gradient. En pratique, cela généralise mieux, surtout pour de gros modèles comme Swin UNETR. Le même lr et le même weight decay sont utilisés pour les cinq modèles, sans réglage par architecture.
Découpage train/val fixe (graine 42)
Les cinq modèles s'entraînent et sont évalués sur exactement le même découpage de 150/50 cas, généré une seule fois et enregistré dans splits.json. Sans cela, un seul tirage aléatoire heureux ou malheureux pourrait expliquer une différence de Dice de 0,003 entre deux modèles. Avec un découpage fixe, toute différence vient de l'architecture, pas de la loterie des données.
MLflow (SQLite en local)
Tous les hyperparamètres et les métriques par époque sont enregistrés automatiquement dans une base SQLite locale. Aucun serveur nécessaire. Le graphique des courbes d'entraînement sur cette page vient directement de cette base. Les courbes sont un enregistrement littéral de ce qui s'est passé pendant l'entraînement, pas une reconstruction après coup.
Activations KAN en fp32
L'évaluation des polynômes de Bernstein passe par le calcul de x⁴, qui perd assez de précision en fp16 pour déstabiliser l'entraînement. La passe avant KAN repasse en fp32 en interne, quel que soit le contexte AMP autour. Petit détail, mais il m'a fallu un moment pour le trouver.
Et ensuite
Entraîner sur le jeu de données complet est la suite la plus directe. WT est la région la plus sensible au volume de données, spatialement diffuse, et c’est là que l’écart avec l’état de l’art publié a le plus de chances de se réduire avec plus de cas. Tout le reste du pipeline est déjà en place. Il ne manque qu’un GPU avec plus de 8 Go de VRAM, et du temps.
CDA-Mamba était la quatrième architecture prévue à l’origine, un modèle Mamba à attention croisée directionnelle qui remplace le coût quadratique de l’attention du Transformer par un balayage linéaire à espace d’états le long des trois axes du volume. J’ai dû le reporter parce que mamba-ssm n’a pas de wheels Windows officielles. C’est celui qui me rend le plus curieux. Si le problème de Swin UNETR était le surapprentissage sur peu de données, l’empreinte plus légère de Mamba, avec un contexte global, pourrait mieux s’en sortir dans ce régime.
HD95 est en partie implémenté dans le code mais n’a jamais intégré l’évaluation finale. Cette métrique repère les cas où un modèle a un bon Dice mais des faux positifs éparpillés loin de la tumeur (la distance de surface au 95e centile entre prédiction et vérité terrain explose dans ces cas-là). Le terminer revient surtout à compléter l’implémentation et à relancer l’évaluation.
Objectifs bonus
Le pipeline se généralise au-delà des tumeurs cérébrales. Entraînement par patches, inférence par fenêtre glissante, évaluation du Dice multi-classes. Rien de tout cela n’est propre à BraTS. Toute tâche d’imagerie médicale 3D avec des séquences multimodales et un déséquilibre de classes similaire entre anatomie et fond s’y prête naturellement, et adapter le pipeline relèverait plus de la configuration que du code.
L’inférence dans le navigateur est l’objectif bonus auquel je reviens sans cesse. Avec 2,42M de paramètres, le KAN U-Net est assez petit pour être exporté en ONNX et tourner via onnxruntime-web, avec une inférence qui s’exécute dans le navigateur du visiteur sur un patch préchargé, sans aucun serveur. Cela transformerait cette page de résultats statique en quelque chose avec lequel on peut vraiment interagir.