Analyse SQL du e-commerce OLIST
Analyse SQL de 100 000 vraies commandes e-commerce brésiliennes, puis les techniques propres à PostgreSQL qui se cachent derrière. Deux notebooks, PostgreSQL 15.
7 min de lecture
- PostgreSQL
- SQL
- Python
- Analyse de données
En bref
Le taux de réachat est de 3 %. La catégorie Santé et Beauté dépasse l’électronique. Le délai de livraison est le meilleur prédicteur de la note laissée par le client, et le goulot d’étranglement est le transporteur, pas le vendeur. São Paulo représente environ 40 % du chiffre d’affaires, tandis que les États du nord paient 30 à 40 % de frais de port en plus.
Ces résultats ne sont que la moitié de l’histoire. Je suis revenu plus tard sur le projet pour écrire correctement le second notebook, en étudiant le fonctionnement interne de PostgreSQL et en mesurant chaque requête (cache chaud, 50 exécutions, médiane, test de Mann-Whitney). Exécuter chaque requête autant de fois a montré que la plupart des conseils d’indexation ne changeaient rien sur ce schéma, le seul vrai gain étant un index couvrant qui a divisé les lectures de buffers par environ 140. Certaines choses ne sont pas encore terminées, et ce sont justement celles sur lesquelles je reviendrai.
Le projet
J’ai construit ce projet pour progresser en SQL. OLIST est une marketplace brésilienne, un peu comme Amazon, dont le jeu de données publié sur Kaggle a assez de tables et de relations pour rendre les requêtes vraiment intéressantes, et assez de lignes pour que la performance commence à compter. Le but n’était pas seulement d’obtenir des réponses. Il s’agissait de travailler des patterns SQL de plus en plus complexes, de comprendre pourquoi ils fonctionnent, et de me constituer un ensemble de techniques que je réutiliserais vraiment.
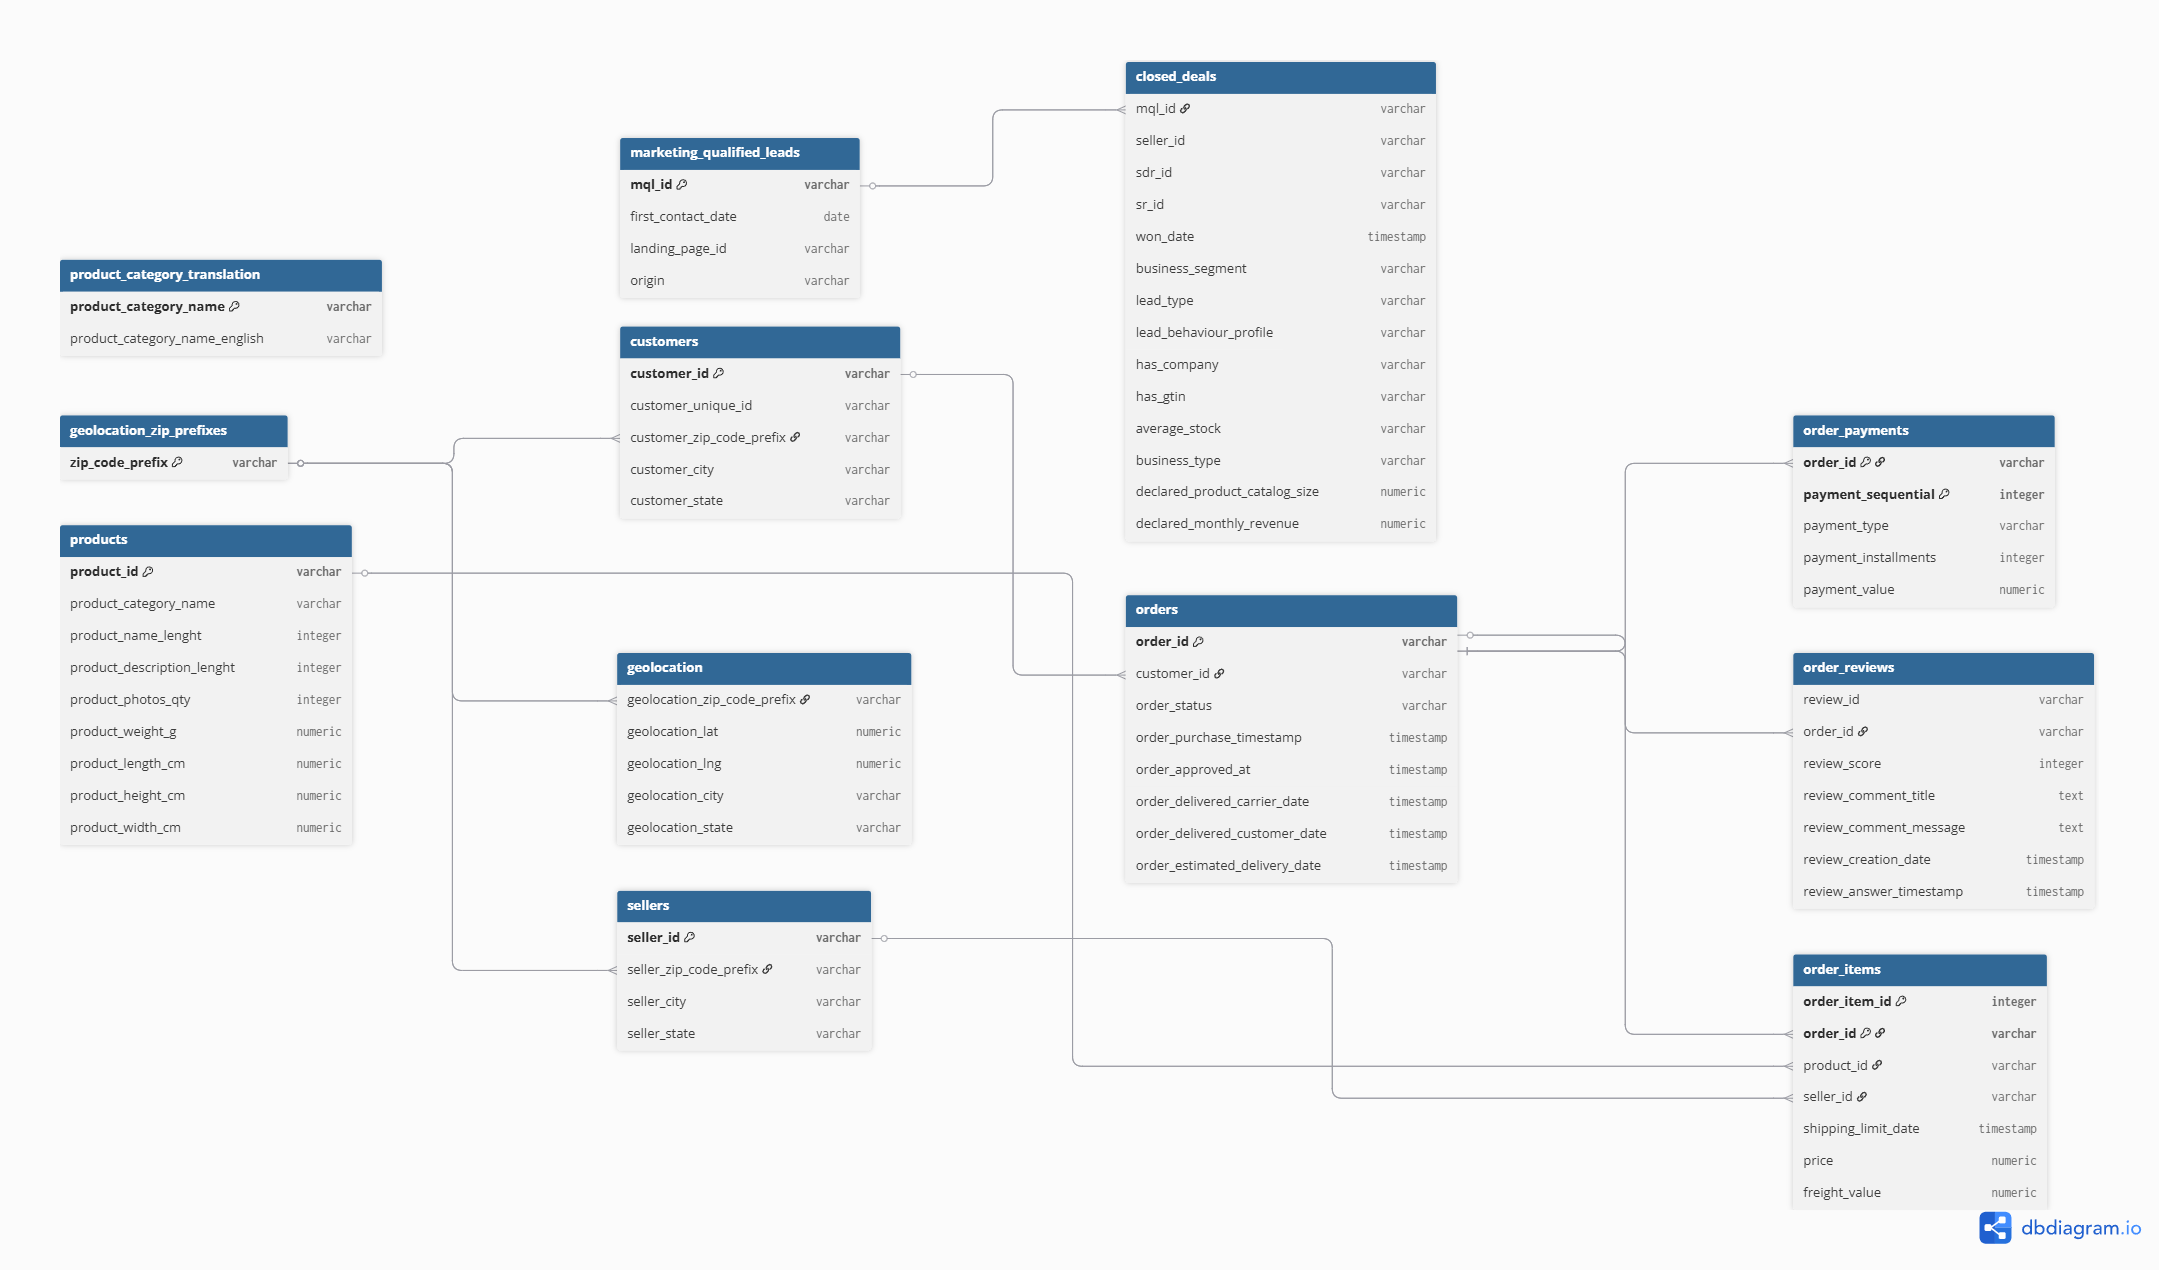
Le jeu de données couvre environ 100 000 vraies commandes passées entre 2016 et 2018, réparties sur 11 tables. Les clients, les vendeurs et les produits sont les entités principales, orders est la table de faits centrale, et order_items, order_payments et order_reviews portent le détail des transactions.
Ce qui ressort
Quelques résultats qui m’ont vraiment surpris. Ce n’est qu’une sélection, l’ensemble se trouve dans les notebooks plus bas.
Côté analyse
- Le taux de réachat tourne autour de 3 %. Presque toutes les commandes viennent d’un premier achat. Je m’attendais à quelque chose de plus proche des 20 à 30 % habituels dans l’e-commerce. L’analyse de cohortes confirme qu’il ne s’agit pas d’un creux passager. Le chiffre est stable pour tous les mois d’acquisition, et la rétention est de loin le plus gros levier dans ces données. (notebook d’analyse, §5 et §10)
- Santé et Beauté mène le chiffre d’affaires, pas l’électronique. Je pensais que les ordinateurs ou les téléphones domineraient. Ce n’est pas le cas, et de loin. Santé et Beauté est une catégorie de consommables, donc les clients devraient revenir, ce qui fait d’un taux de réachat de 3 % dans un catalogue fait pour le réapprovisionnement une contradiction qui mérite d’être comprise. (notebook d’analyse, §6)
- Le délai de livraison prédit la note mieux que tout le reste. Les commandes livrées en 0 à 3 jours obtiennent en moyenne 4,46 étoiles. Celles qui prennent plus de 22 jours tombent à 3,01. Le résultat moins évident, c’est que le goulot d’étranglement se trouve chez le transporteur (environ 9,3 jours de transit) plutôt que chez le vendeur (environ 2,8 jours avant l’expédition). Demander aux vendeurs d’expédier plus vite n’est pas la bonne solution. (notebook d’analyse, §7)
- São Paulo représente environ 40 % du chiffre d’affaires. Les clients des États du nord (AM, PA, RR) paient des frais de port de 30 à 40 % du prix de l’article, parce que presque tous les vendeurs sont basés à SP. Ils paient plus et attendent plus longtemps. C’est un problème d’offre autant que de demande. (notebook d’analyse, §4)
- Les clients « à risque » représentent une opportunité de réengagement de 5,7 M R$. La segmentation RFM classe 23 572 clients comme « à risque », soit 5,7 M R$ de chiffre d’affaires venant de personnes qui ont déjà acheté ici une fois. Les reconquérir coûte moins cher que d’en trouver de nouveaux, et les données pour les identifier existent déjà. (notebook d’analyse, §9)
Côté optimisation
- Un index couvrant a divisé les lectures de buffers par environ 140. Dès que la requête ne demandait plus que les deux colonnes portées par l’index, Postgres est passé à un
Index Only ScanavecHeap Fetches: 0sans jamais toucher la table principale. Les lectures de buffers sont tombées de 104 762 à 746, et contrairement aux temps bruts, ce ratio reste parfaitement stable d’une exécution à l’autre. (notebook des techniques, §11) - La plupart des conseils d’indexation classiques n’ont rien changé sur ce schéma. Mesurés proprement (cache chaud, 50 exécutions, médiane, Mann-Whitney), l’index sur clé étrangère comme l’index sur expression ont laissé le plan d’exécution inchangé. La leçon, c’est que ce sont les compteurs de buffers, et non les p-values, qui disent si un index travaille vraiment. (notebook des techniques, §11)
Schéma
11 tables. orders est au centre, et relie les clients aux articles qu’ils ont achetés, aux paiements qu’ils ont faits et aux avis qu’ils ont laissés. Chaque order_item associe une commande à un produit et à un vendeur précis, tandis que clients et vendeurs se rattachent à la géolocalisation via les préfixes de codes postaux brésiliens. Cette organisation en étoile (des tables de faits transactionnelles entourées de dimensions descriptives) est ce qui rend le jeu de données si adapté aux jointures, agrégations et fonctions de fenêtrage utilisées tout au long du projet.
Cliquez en dehors du diagramme ou appuyez sur Échap pour le libérer.
Le diagramme montre un petit nœud geolocation_zip_prefixes. Ce n'est pas une table de base mais une clé de référence pour le préfixe de code postal partagé, c'est pourquoi on compte 11 tables et non 12.
Les notebooks
Le projet est réparti sur deux notebooks. Le premier est le parcours d’entraînement à travers l’analyse. Le second est celui où j’ai ralenti pour travailler correctement les techniques propres à PostgreSQL et l’optimisation des requêtes. Les deux sont repliés ci-dessous. Cliquez sur une barre pour l’ouvrir.
▶ Notebook d'analyse - Analyse principale Croissance du chiffre d'affaires, performance géographique, comportement client, segmentation RFM, rétention par cohorte, plus une partie 2 sur les techniques SQL. Cliquer pour ouvrir ▼ Cliquer pour replier ▲
▶ Techniques et optimisation Études de cas d'indexation (EXPLAIN ANALYZE avant/après) et sept techniques PostgreSQL : CROSSTAB, agrégats FILTER, jointures LATERAL, CTE récursives, fonctions de fenêtrage, agrégation JSON, DISTINCT ON. Cliquer pour ouvrir ▼ Cliquer pour replier ▲
Et ensuite
Quelques pistes que j’ai laissées ouvertes, surtout dans le second notebook, et que je reprendrais de la même façon que le reste.
- Mettre la géographie sur une vraie carte. La concentration à São Paulo ne saute aux yeux sur un diagramme en barres que si l’on sait déjà où regarder. Une carte choroplèthe de la densité de commandes par État brésilien la rendrait évidente en un coup d’œil, et la requête sur le chiffre d’affaires par État renvoie déjà tout ce dont la carte a besoin.
- Intégrer le canal d’acquisition à l’histoire de la rétention. La table des leads marketing est restée inutilisée pendant tout le projet. Elle contient des données de canal d’acquisition qui permettraient de relier les segments de clients à leur provenance. Pour l’instant, le taux de réachat de 3 % ressemble à un problème de produit. Il pourrait s’avérer être un problème de canal une fois la source prise en compte.
- Ajouter des intervalles de confiance au lien entre livraison et note. La tendance entre les tranches de délai est nette, mais je voudrais des intervalles bootstrap avant d’avancer un chiffre précis. Le sens de l’effet ne fait pas de doute. C’est son ampleur qui reste à préciser.
- Évaluer les vendeurs sur ce qu’ils annulent, pas seulement sur ce qu’ils livrent. L’analyse actuelle des vendeurs ne regarde que les commandes livrées, ce qui excuse discrètement ceux dont le vrai problème est de ne jamais arriver jusqu’à la livraison. Les taux d’annulation et de remboursement compléteraient le tableau.
Objectif bonus
Mettre le tout derrière un petit tableau de bord interactif. Chaque requête renvoie un résultat propre, donc brancher les principales sur un tableau de bord léger transformerait une page de constats statiques en quelque chose que le lecteur peut vraiment manipuler. C’est plus de la plomberie que de l’analyse, mais cela rendrait le travail bien plus facile à explorer sans ouvrir de notebook.
Comment le lancer
Environnement de développement : identifiants en dur, Postgres sur un seul nœud, rien de durci pour la production. Il vous faut Docker Desktop, plus Python 3.10 ou plus récent pour les notebooks.
docker-compose up -d # démarre PostgreSQL 15
docker-compose exec postgres psql -U postgres -d olist_db -c "\dt" # vérifie que les tables sont chargées

pip install -r notebook_requirements.txt
jupyter lab sql_practice_notebook.ipynb # ouvre l'analyse
Paramètres de connexion :
| Champ | Valeur |
|---|---|
| Host | localhost |
| Port | 5432 |
| Utilisateur | postgres |
| Mot de passe | postgres |
| Base de données | olist_db |
Le jeu de données OLIST est publié sous licence CC BY-NC-SA 4.0 sur Kaggle. Les CSV se téléchargent séparément.